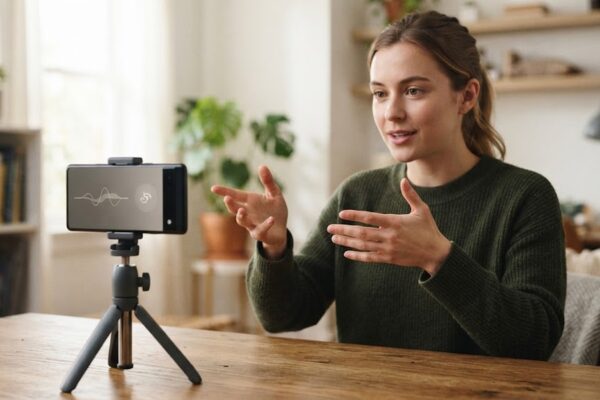
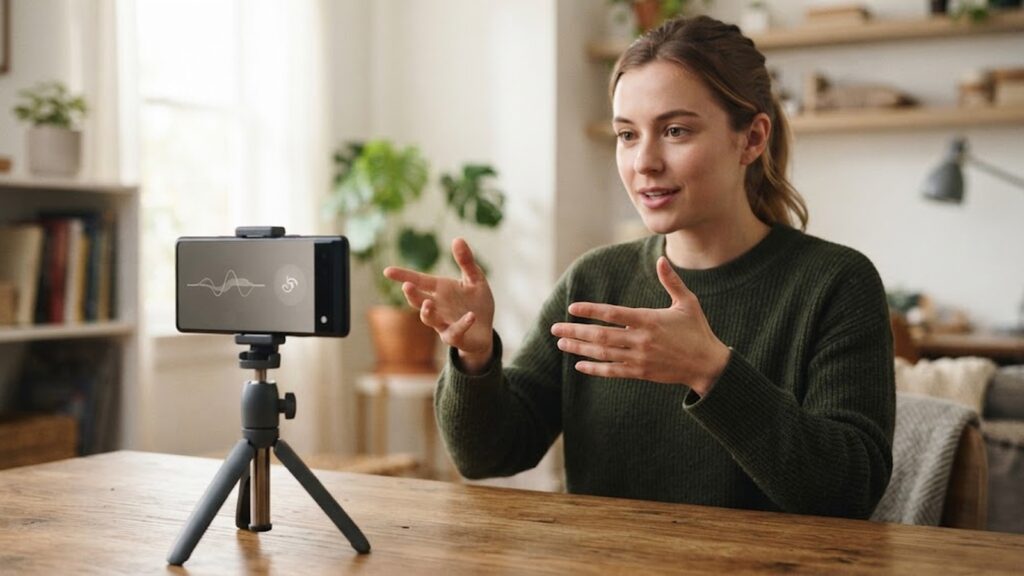
Человек показывает жесты в камеру — телефон превращает их в текст. Почему это сложнее распознавания речи?
Человек садится перед смартфоном, показывает несколько жестов — и в поле ввода появляется английская фраза. Не набор букв и не подсказка «возможно, вы имели в виду», а готовый текст, который можно отправить в мессенджере или вставить в поисковую строку. 12 августа 2026 года Google DeepMind представила систему SL2T…