ИИ пишет черновики быстрее. Почему редактура стала новым узким местом
В эксперименте с профессиональными письменными задачами ChatGPT сократил среднее время работы примерно на 40%, а оценённое качество результата выросло примерно на 18%. Это данные контролируемого исследования, опубликованного в Science, и касаются они конкретных заданий и конкретных участников, а не всего рынка контента. Но сам сдвиг они показывают неплохо: часть письменной работы, которая раньше требовала времени, теперь можно выполнить быстрее.
Из этого легко сделать вывод, что контент подешевел. Он и подешевел — но только одной частью. Черновиком. Тем самым первым текстом, который раньше надо было выдавить из себя, а теперь достаточно попросить. По-моему, именно здесь произошла тихая смена узкого места: дефицитом стала не генерация, а приёмка.
Черновик подешевел, а производственный цикл — нет
Разница между «текст есть» и «текст можно публиковать» никуда не исчезла. Она просто переехала в конец маршрута, туда, где стоят проверки: факты, стиль, повторы, уместность и финальное решение выпустить это в свет. Ни один из этих этапов не ускоряется сам по себе от того, что черновик появился за минуту. Скорость генерации при этом не устраняет риск уверенно сформулированных ошибок и может увеличить объём текста, который придётся проверять.
Полезно посмотреть, как эффект ИИ вообще распределяется между людьми. В исследовании NBER на 5 179 операторах поддержки генеративная модель дала в среднем около 14% прироста производительности, причём менее опытные сотрудники выигрывали заметно сильнее, а у самых опытных прирост был скромным. Это не про редактуру, и переносить такие цифры на производство контента можно только как осторожную гипотезу, а не как измеренный факт.
Если эта логика хотя бы отчасти переносится на тексты, выходит неприятная для контент-заводов вещь. Быстрый черновик выравнивает низ, но не поднимает верх. Верх — это как раз то, что делает текст пригодным: проверенные факты, точные формулировки, отсутствие воды. И эта работа никуда не делась.
Правдоподобно — не значит правильно
Одна из главных особенностей языковых моделей в том, что они могут одинаково уверенно звучать и при изложении верного, и при изложении ошибочного содержания. NIST в профиле рисков генеративного ИИ называет это конфабуляцией: уверенным изложением ошибочного, ложного или противоречивого содержания. Причём речь не только о цифрах — модель с той же бодростью может выдумать цитату, аргумент или ссылку на источник, которого не существует.
Исследование Google DeepMind о фактичности длинных ответов показывает, как с этим пытаются бороться технически. Длинный ответ разбивается на отдельные утверждения, и каждое проверяется по поиску — подход получил название SAFE. В описанной исследователями методике автоматизированная проверка может быть заметно дешевле человеческой разметки, но гарантией истины не является: она опирается на качество поиска и всё равно не отменяет финальную человеческую проверку.
Практический вывод из этого простой и слегка нудный. Проверки текста «целиком на правдивость» недостаточно. Её нужно дополнять проверкой по кускам: даты, названия, версии, цифры, статусы, цитаты и причинно-следственные связки. Пока эти куски не сверены по отдельности, перед нами не статья, а хорошо написанное предположение.
Шаблонность — это не косметика
Бывает хуже: текст честный, факты сходятся, а читать невозможно. NIST отдельно фиксирует риск нежелательной гомогенизации — генеративные системы могут выдавать чрезмерно похожие, повторяющиеся и менее разнообразные результаты. Это описание зафиксированного риска, а не приговор каждому конкретному тексту, но игнорировать его странно.
Шаблонность обычно ищут не там. Дело не в отдельных словах, а в устройстве текста: одинаковые заходы, предсказуемые связки, гладкие абзацы без конкретики, одна и та же мысль, пересказанная трижды разными словами. Одно из возможных объяснений, почему так выходит, — модель училась на большом массиве похожих текстов и по умолчанию может тянуться к усреднённому. Это именно моя интерпретация, а не измеренный вывод из исследования; но следствие от неё не зависит. Если не вмешаться, конвейер начнёт производить не плохие статьи, а одинаковые. На мой взгляд, это опаснее отдельной фактической ошибки: ошибку читатель хотя бы может заметить, а одинаковость просто перестаёт замечать и уходит.
Поэтому редактура — не косметика и не расстановка запятых. Это удаление пустоты: воды, повторов, ложных обобщений. И замена её конкретикой, за которую автору не стыдно.
Что на самом деле делает редактор
Здесь полезно вспомнить исследование о профессиональных редакторах, которые перерабатывали деловые письма с помощью ChatGPT. Модель предлагала варианты переписывания и локальные исправления. Но проблему в тексте определял человек, цель правки ставил человек, результат оценивал человек, и он же решал, что попадёт в финал. Оговорка обязательна: в исследовании участвовали шесть редакторов и четыре письма, так что это аккуратный вывод о механике работы, а не измерение всей отрасли.
В такой схеме роль редактора смещается, но не исчезает: меньше писать с нуля, больше быть оператором качества. Ставить задачу, выбирать источники, держать в голове аудиторию, проверять факты, оценивать уместность и в конце говорить «да» или «нет». Последнее — самое дорогое, потому что за «да» кто-то должен отвечать.
Auto-Dzen: пять стадий вместо одного рывка
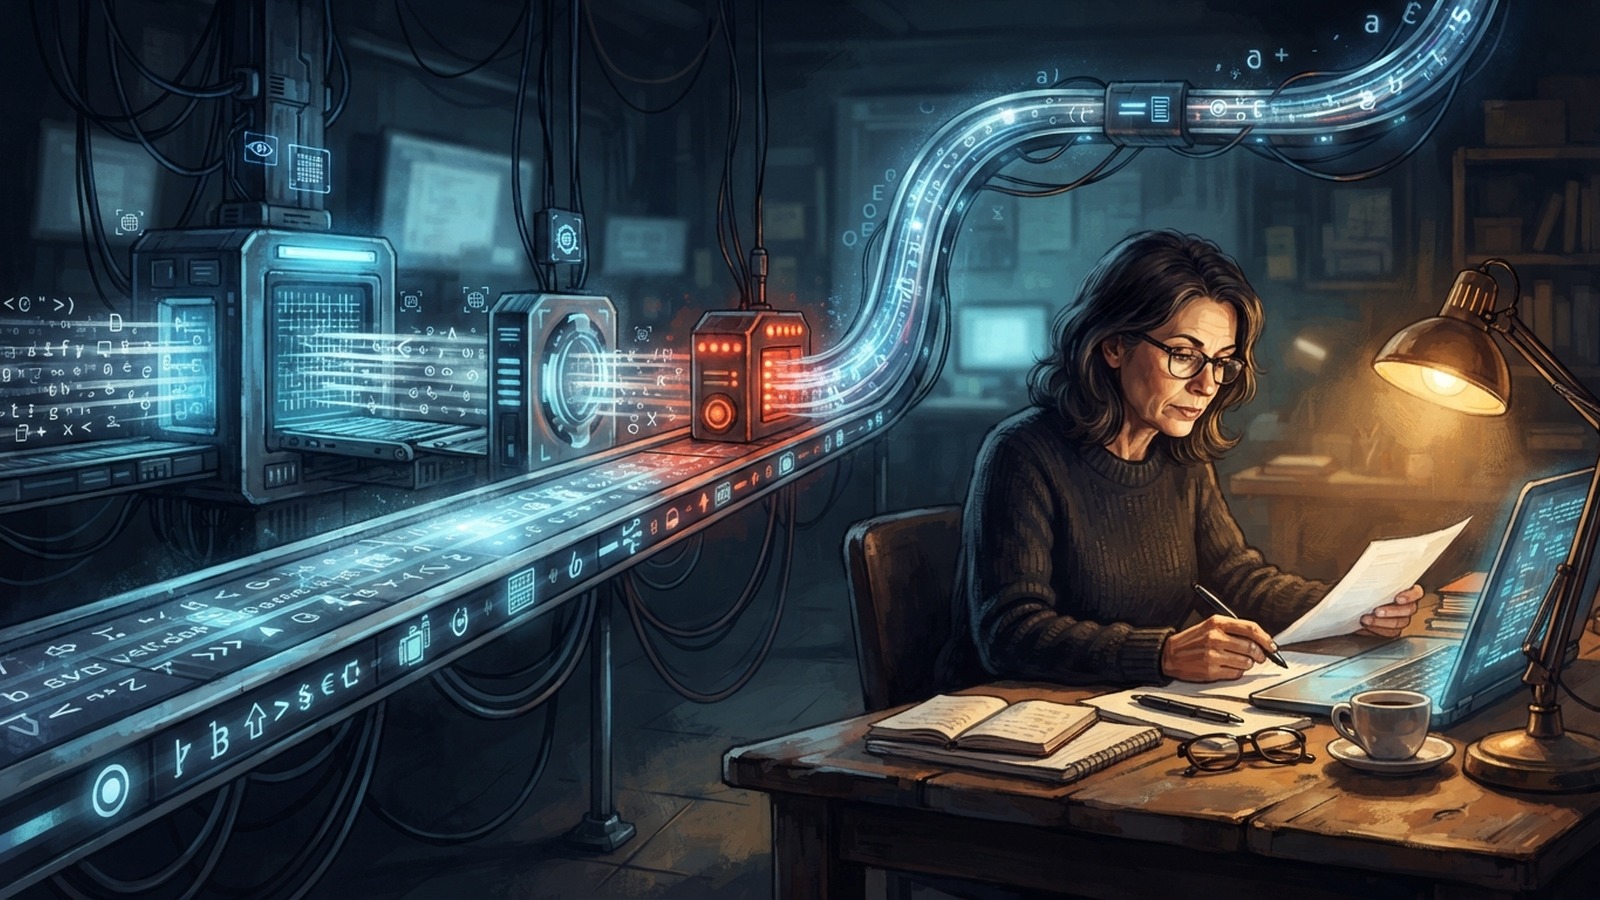
Именно поэтому смотреть стоит не на отдельную нейросеть, а на всю схему производства. В материалах GPT-Лаборатории Auto-Dzen описан как конвейер, который может передавать готовый материал дальше — например, на сайт и в RSS. Рабочую схему удобно разобрать по шагам: draft → edit → factcheck → review → cover.
Что делает каждый шаг, понятно быстро. draft — получить рабочий черновик и не тратить силы на пустой лист. edit — убрать слабые формулировки, повторы и шаблонные связки, вернуть тексту ритм. factcheck — проверить внешние утверждения по отдельности, а не «в целом». review — принять или отклонить материал целиком, вместе с решением о публикации. cover — сделать обложку уже после того, как тема и смысл зафиксированы, а не вместо них.
Ценность здесь не в отдельных инструментах, а в разделении ответственности. У каждой стадии своя задача и свой критерий приёмки. Когда всё сваливается в один запрос «напиши хорошую статью», критериев нет вообще: результат либо нравится, либо нет, и обычно он нравится просто потому, что уже готов. Оговорка: независимого аудита производительности и качества Auto-Dzen в открытых источниках нет. Это пример архитектуры, а не доказанный отраслевой стандарт. И сам конвейер качества не гарантирует — оно зависит от критериев проверки, источников, настроек этапов и компетентности того, кто нажимает финальную кнопку.
Признаков рабочего конвейера немного, и они скучные. Есть отдельный этап проверки фактов, а не «проверим по ходу». У редактуры есть критерии, а не только ощущение «звучит гладко». Повторы и шаблонность вычищаются осознанно. Финальное решение принимает человек, у которого есть право отклонить материал. Обложка и вся публикационная обвязка делаются после фиксации смысла.
У фабрики брака всё наоборот. Текст публикуется потому, что он уже сгенерирован. «Фактчекинг» сводится к доверию модели. Редактура ограничивается орфографией. Из статьи в статью кочуют одинаковые структуры и заходы. И главное — никого не назначили ответственным за финальное «да». Разница между этими двумя схемами не в скорости: она может быть совершенно одинаковой. Разница в количестве поводов для красных щёк.
ИИ действительно снял барьер пустого листа и ускорил письменные задачи — это подтверждено экспериментом, а не маркетинговой брошюрой. Но между «текст есть» и «текст можно публиковать» по-прежнему лежит вся редакционная работа, и она не исчезает и не сокращается автоматически вместе со временем генерации. Ценность сместилась туда, где её раньше никто не считал отдельно: в контроль качества. Проверить, убрать шаблон, удержать голос, заметить повтор и принять решение — вот что теперь занимает время. Контент-завод без редакционной системы — это просто быстрый способ выпускать брак, причём с уверенным тоном и красивой обложкой.
«Написать» стало простым этапом. «Принять хороший текст» — по-прежнему работа, за которую кто-то должен отвечать.
Если разбираться в таких схемах хочется не по одному материалу, а системно, продолжение логично искать в GPT-Лаборатории: там разбирают конвейеры, инструменты и практические кейсы применения ИИ. Основной канал — Telegram: https://t.me/jopotology. Есть и другие площадки, если удобнее там: ВКонтакте — https://vk.ru/jopotology, MAX — https://max.ru/join/fyssUhvFi8Bo2GK0bm6F_RFKZYTa1LWL8VVJnRMkTHM.