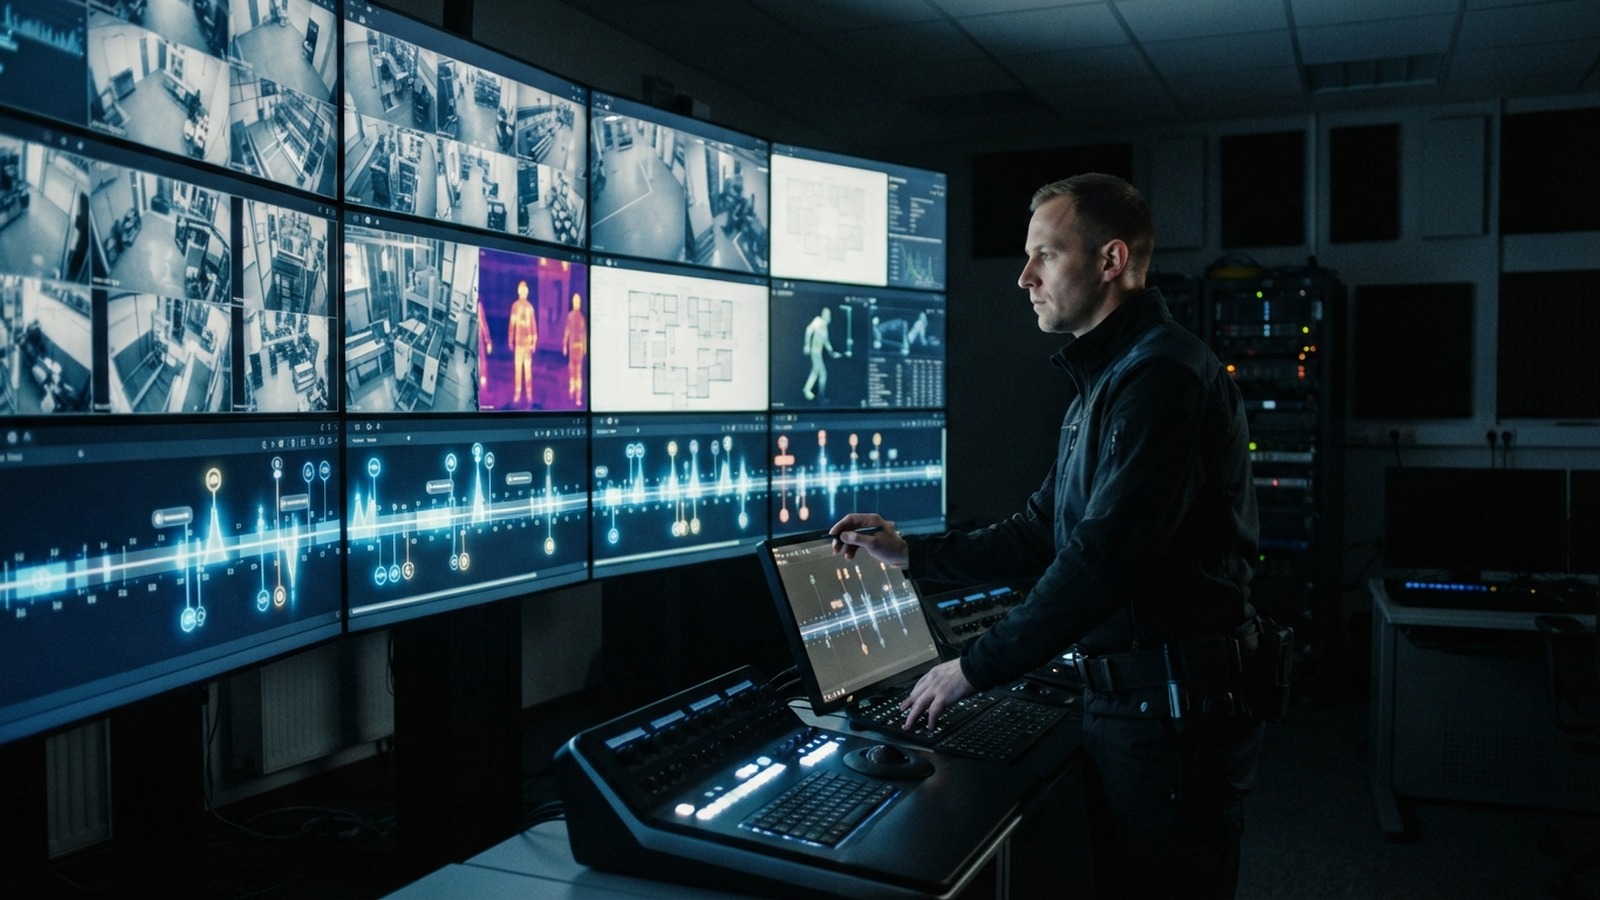
Часовая запись цеха и вопрос «В какой момент оператор открывает защитный кожух?» — хороший тест для видеоагента. Полезный ответ здесь — не гладкий пересказ записи, а несколько временных меток и предложение открыть конкретные куски, где видно движение руки, снятую крышку и реакцию соседнего станка. Разница примерно как между пересказом фильма и поиском кадра, где герой кладёт ключ в карман: в первом случае можно складно рассказать сюжет и всё равно не ответить на вопрос, во втором нужен конкретный момент, который можно открыть и проверить. Дальше речь об агентном анализе видео: модель получает вопрос, ищет релевантные фрагменты, сопоставляет события и при необходимости возвращается к выбранным интервалам. Главный тезис простой: полезный видеоагент ищет доказательство ответа внутри записи, а не просто пересказывает её. Это более узкая, но и более честная задача, чем «понимание любого видео».
Как агент ищет событие, а не «смотрит видео»
Сначала уберём популярное представление: модель не садится перед экраном и не смотрит час записи так, как это делает человек. В обычном, статическом режиме Gemini, по документации Google, извлекает примерно один кадр в секунду. Такой подход экономит ресурсы, но у него есть понятная слабость: быстрые движения и короткие смены сцен могут попасть между анализируемыми кадрами. Google прямо предупреждает об этом в документации.
Агентный режим устроен иначе. Модель динамически перемещается по временной шкале, сама выбирает, какие фрагменты, субтитры, аудио и кадры изучать, и может менять частоту кадров и разрешение под конкретный запрос. Грубо говоря, сначала она ищет вероятное место, а потом возвращается туда и смотрит внимательнее. Это важная разница: не «просмотреть всё с одинаковой детализацией», а «сузить область и проверить подозрительный участок».
Исследовательская логика здесь примерно та же. Работа T* (CVPR 2025) делит задачу на три этапа: привязку вопроса к видео, итеративный временной поиск и выполнение основной задачи уже на найденных фрагментах. Смысл в том, чтобы не тащить в модель весь часовой массив одинаково подробно, а сначала найти окно, где ответ вообще может находиться. Потом это окно можно рассмотреть плотнее, а не делать вид, что один и тот же уровень внимания полезен для всей записи.
Есть и другой вариант архитектуры. Система AVA, представленная на USENIX NSDI 2026, строит событийные графы для длинных или непрерывных видеопотоков, а затем использует агентный механизм поиска и генерации ответа. В экспериментах AVA-100 использовались восемь видео длительностью более десяти часов и 120 вопросов к ним. Это описание метода и состава теста, а не обещание, что так же будет работать любая заводская запись. Именно здесь проходит граница между исследованием и повседневным продуктом: метод может быть убедительным, но заявленные результаты всё равно остаются результатами конкретного эксперимента.
Пересказ, доказательство и неприятная разница между ними
Самый простой тест для любого видеоагента звучит не «о чём это видео», а «покажи, где это видно». Ответ без интервала — это пересказ, пусть и полезный. Ответ с интервалом — заявка на проверяемость: человек может открыть указанный кусок и убедиться, что модель не придумала событие по общему впечатлению.
Проблема в том, что наличие временной метки само по себе ничего не гарантирует. Исследование VideoSEAL (ICML 2026) описывает расхождение доказательства и ответа: система может сформулировать правильный или просто правдоподобный ответ, но найденные и проверенные ею кадры этот ответ не подтверждают. Авторы предлагают разделять планирование поиска и выдачу финального ответа, добавляя проверку на уровне визуального содержания. Иначе говоря, мало найти похожий кадр — нужно убедиться, что он действительно является основанием для вывода.
Другой подход, VideoHV-Agent (CVPR 2026), предлагает сначала превращать варианты ответа в проверяемые гипотезы, затем выводить из них признаки, которые нужно проверить в конкретных интервалах видео, и только после этого формировать итоговый ответ. Логика почти детективная: не «мне кажется, это произошло там», а «если это произошло там, то в кадре должно быть вот это, это и вот это». Такой порядок действий полезен уже сам по себе, потому что заставляет систему сформулировать, что именно она собирается доказать.
Длинные записи усложняют задачу ещё и потому, что нужно сопоставлять события, разнесённые по времени. В LongVideoBench есть вопросы, где требуется сравнить состояние объекта или действие в разных частях ролика: например, определить, что изменилось в рюкзаке персонажа между началом и более поздним эпизодом. Один удачный кадр такую задачу не решает. Нужно найти несколько мест, удержать их в связке и не перепутать порядок событий.
Поэтому временная метка — это ориентир, а не печать «доказано». В бытовом сценарии она экономит время: не нужно вручную перематывать весь архив. В критичном сценарии она лишь подсказывает, куда смотреть человеку или отдельной проверяющей системе. Если пропустить этот шаг, красивый ответ начнёт выглядеть убедительнее, чем он есть.
Где это может работать: производство, обучение, архивы
Сценарии применения здесь довольно понятные, если не обещать больше, чем есть. На производстве запрос может звучать так: «В какие моменты оператор открывает защитный кожух?» Рабочая схема выглядит так: поиск по речи и общей структуре записи, выделение вероятных интервалов, повторный просмотр с более высокой частотой кадров. Оговорка обязательна: короткое движение, которое длится меньше интервала между анализируемыми кадрами, можно не заметить. Для контроля качества это не мелочь, а принципиальное ограничение.
В обучении полезен другой тип вопроса: «Где преподаватель впервые объясняет разницу между двумя методами?» Здесь система может сначала искать по расшифровке речи, а затем проверить слайды, жесты, демонстрацию формул или запись экрана. Это именно поиск по содержанию, а не автоматическое составление конспекта. Разница практическая: конспект можно читать и не проверять, а найденный фрагмент всё равно придётся открыть.
В видеотеках и архивах задача становится ближе к temporal grounding — привязке текстового запроса к конкретному временному интервалу. Запрос вроде «найди эпизоды, где герой возвращается к красной машине после разговора» требует совместить персонажа, объект, действие и порядок событий. Один признак здесь ничего не решает: красная машина может быть в кадре, герой может быть рядом, но нужный эпизод — только тот, где есть возвращение после разговора.
Отдельный сценарий — долгие наблюдаемые процессы. Вопрос «когда впервые появляется неисправность и что происходило за пять минут до неё» требует не только найти вероятный момент, но и расширить окно анализа назад, чтобы проверить контекст. Именно здесь полезен итеративный поиск: грубое обнаружение, уточнение, проверка соседних интервалов. Но и здесь поиск событий в видео остаётся поиском доказательств, а не универсальным распознаванием любого события.
Где агентный анализ видео ломается
Первая и самая понятная зона риска — быстрые, короткие или частично перекрытые события. Если событие короче шага между анализируемыми кадрами, никакая красивая формулировка про «понимание видео» не поможет. В документации Google это сказано достаточно прямо: при равномерном прореживании можно пропустить быстрые движения и короткие смены сцен. Агентный режим позволяет вернуться к выбранному интервалу и изучить его с большей частотой кадров или разрешением, но не отменяет риск полностью.
Второе ограничение — техническое. Для моделей с контекстом 1 млн токенов Google указывает ориентир до трёх часов видео при низком разрешении или до одного часа при высоком. Это предел конкретной конфигурации, а не свойство всех видеомоделей, и он может меняться вместе с версиями API. Полезно держать это в голове, когда в рекламном тексте обещают «часовое видео любой сложности» без уточнений про разрешение и режим обработки.
Третье — неверное предположение, что агентный режим всегда лучше обычного. Это зависит от задачи. Для длинной записи с редкими событиями выборочный поиск может быть эффективнее. Для покадрового контроля, где важно каждое движение, агрессивное прореживание кадров опасно. На мой взгляд, правильный вопрос звучит не «какой режим современнее», а «какое событие мы ищем и какой ценой готовы его пропустить».
И главный риск для практики — правдоподобный ответ без достаточного визуального подтверждения. Модель может назвать момент уверенно, гладко и даже правильно, но выбранный фрагмент не будет содержать нужного доказательства. В критичных сценариях это лечится только проверкой человеком или отдельным модулем проверки. Видеоагент здесь похож на внимательного ассистента, который приносит папку с закладками: полезно, но окончательное решение всё равно за тем, кто открывает папку.
Как формулировать запрос и что проверять
Практический вывод довольно простой. Вместо «что происходит на видео» лучше спрашивать «найди момент, где… и покажи интервал». Вместо «сделай обзор записи» — «перечисли возможные эпизоды, а затем проверь каждый по кадрам». Чем конкретнее признак, который может подтвердить ответ, тем меньше пространства для красивой догадки.
Проверять стоит не только текст ответа, но и сам фрагмент. Если система говорит «оператор открыл кожух», нужно посмотреть, что в этот момент видно: рука, крышка, последовательность движения. Если система говорит «преподаватель объяснил разницу», нужно проверить, есть ли на записи слайд, формула, жест или хотя бы слова, которые это подтверждают. Временная метка без такого просмотра остаётся обещанием, а не доказательством.
Полезно разделять несколько уровней задач: обзор записи, поиск момента и доказательство события. Обзор может быть приблизительным. Поиск момента уже требует интервала. Доказательство требует, чтобы интервал действительно содержал признаки, на которые ссылается ответ. Смешивать эти уровни в одном запросе удобно, но потом трудно понять, где система ошиблась — в поиске, в интерпретации или в формулировке.
Если хочется проверять такие сценарии на своих записях и следить за практическими разборами ИИ, можно заглянуть в GPT-Лабораторию — https://t.me/jopotology. Там больше про применение инструментов и меньше про обещания, что каждая модель видит каждый кадр.
В итоге ценность агентного анализа видео не в том, что модель «посмотрела час записи». Ценность в том, что она умеет вернуться к нужной минуте, показать основание и — в хорошем варианте — признать, что найденный фрагмент ответ не подтверждает. Подход рабочий и полезный там, где ответ можно проверить. И опасный там, где красивую временную метку принимают за доказательство, не открывая сам кадр.