Разговор — это далеко не только слова.
Человек говорит «ну да, конечно» и одновременно пожимает плечами — получаем один смысл. Говорит те же слова и энергично кивает — уже другой. Машет рукой, показывает большой палец, качает головой, указывает пальцем, меняет выражение лица.
Большую часть этой информации мы вообще не замечаем, пока не исчезает возможность двигаться.
Люди с тяжёлым параличом уже могут использовать нейроинтерфейсы для набора текста или даже синтеза речи непосредственно из сигналов мозга. Но до сих пор получалось довольно странное общение: мозг человека способен выразить куда больше, а компьютер выдаёт наружу в основном слова.
Команда Калифорнийского университета в Сан-Франциско сделала следующий шаг.
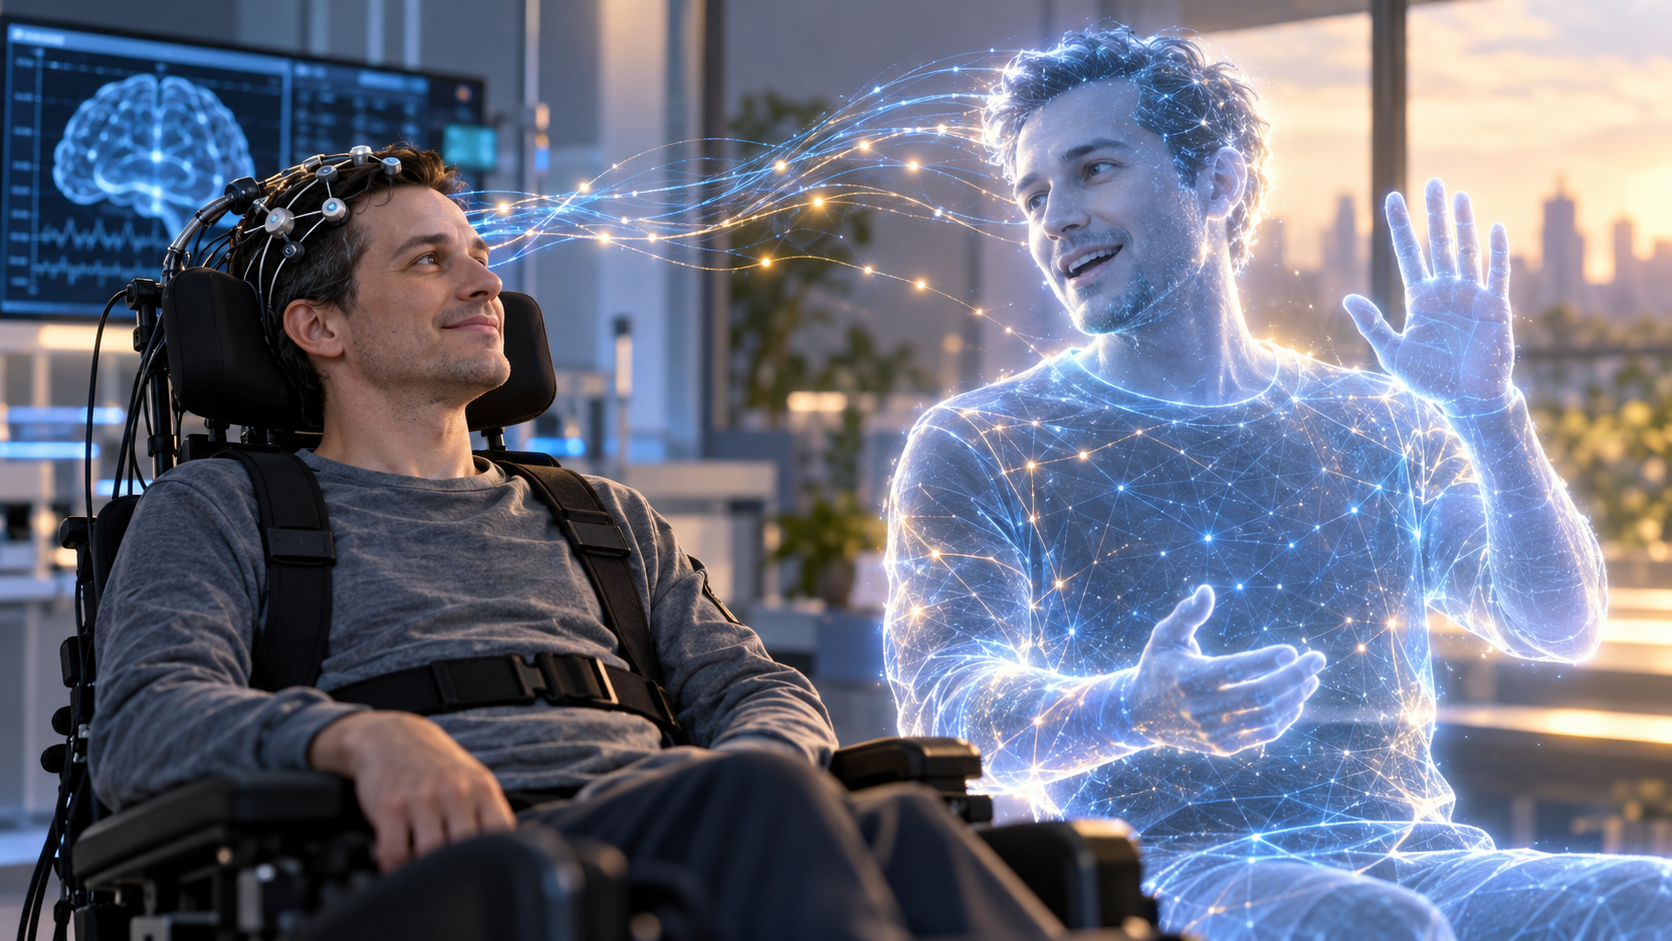
Один имплант научился одновременно распознавать попытку произнести фразу и намерение сделать жест, а затем передавать оба действия цифровому аватару.
Получилось что-то вроде нового тела.
Пока виртуального.
До этого нейроинтерфейс в основном возвращал голос
Сама лаборатория Эдварда Чанга занимается такими системами уже много лет. В 2021 году они показали декодирование небольшого словаря из мозговых сигналов человека, который после тяжёлого паралича потерял возможность нормально говорить.
Потом словарь расширялся. Появился быстрый перевод мозговой активности в текст, затем синтез речи и цифровое лицо, способное двигать губами и воспроизводить мимику.
В 2023 году одна из систем уже выводила речь со скоростью около 78 слов в минуту и заставляла виртуальный аватар произносить декодированные фразы. Причём голос можно было приблизить к голосу человека до болезни.
Выглядит впечатляюще.
Но человек — всё-таки не говорящая голова.
Попробуйте разговаривать вообще без тела
Не двигайте руками. Не кивайте. Не качайте головой. Не пожимайте плечами. Постарайтесь даже не менять позу.
Формально вы продолжаете нормально разговаривать.
Практически беседа становится довольно деревянной.
Жесты дополняют речь, иногда заменяют её, а иногда полностью меняют значение слов. Простое пожатие плечами может означать «не знаю», «мне всё равно», «ну а что я могу сделать?» — и собеседник прекрасно считывает оттенок из контекста.
Поэтому исследователи решили возвращать не ещё несколько процентов точности распознавания текста.
Они попробовали вернуть мультимодальное общение.
Для этого использовали один имплант
В исследовании участвовали три человека с тяжёлым параличом. Причинами были, в частности, поражение ствола мозга и боковой амиотрофический склероз.
На поверхности сенсомоторной коры у участников находилась высокоплотная электродная решётка ECoG. Она не читает мысли в голливудском смысле, а регистрирует электрическую активность больших групп нейронов возле поверхности мозга.
Человек пытается произнести фразу — появляется определённый рисунок активности.
Пытается поднять руку — другой.
Кивнуть.
Пожать плечами.
Помахать рукой.
Показать большой палец.
Исследователи собирают такие примеры, а модели машинного обучения ищут закономерности между активностью мозга и намерением выполнить действие.
Главное новое достижение состоит в том, что для речи и жеста больше не требуются два отдельных нейроинтерфейса.
Один участок электродов может давать достаточно информации для обоих каналов.
Но мозг приготовил исследователям небольшую подлянку
Казалось бы, всё просто.
Сначала обучаем модель распознавать речь.
Отдельно учим её распознавать жесты.
Потом запускаем обе одновременно.
Только человек редко устроен так удобно для программиста.
Когда мы говорим и одновременно двигаем рукой, мозговая активность не оказывается простым сложением:
речь + рука.
Картина меняется.
Часть областей моторной коры участвует в нескольких действиях, сигналы перекрываются, а совместное действие создаёт собственный рисунок активности.
Модель, обученная только на изолированных жестах и отдельно на речи, при их совмещении начинает ошибаться чаще.
Исследователям пришлось показать ей именно совместное поведение.
И после этого качество заметно выросло.
По сути модель пришлось научить разговаривать как человек
Это довольно занятная деталь.
Мы часто обучаем ИИ на искусственно упрощённых задачах. Вот здесь только текст. Здесь только изображение. Здесь отдельно движение руки.
А настоящий человек существует сразу во всех каналах.
Он говорит и двигается.
Смотрит и слушает.
Меняет выражение лица.
Реагирует на собеседника.
И постепенно нейроинтерфейсы упираются в ту же проблему, что робототехника и мультимодальные модели: реальный мир не любит аккуратно раскладываться по папкам.
Чтобы вернуть естественное поведение, приходится считывать его целиком.
А затем на экране появился цифровой человек
В следующем этапе участвовали уже двое из трёх участников исследования.
Для каждого сделали персонализированный полнотелый виртуальный аватар. Человек сидит практически неподвижно, пытается произнести фразу и одновременно представляет или пытается выполнить нужный жест.
Модель анализирует активность мозга.
Речь появляется на экране как текст.
А цифровое тело выполняет соответствующее движение.
Пользователь может кивнуть.
Покачать головой.
Помахать рукой.
Пожать плечами.
Сделать другие простые коммуникативные жесты.
Само физическое тело человека при этом может почти не двигаться.
Но намерение всё равно существует в моторной коре — и именно его машина превращает в действие аватара.
Тут важно не написать лишнего
Человек не получил обратно физический контроль над парализованной рукой в результате этого конкретного исследования.
Имплант не заставляет его мышцы двигаться.
Он считывает сигнал, который раньше должен был уйти к телу, и отправляет его другому исполнителю — компьютеру.
Поэтому «цифровое тело» здесь довольно точная метафора.
Мозг пытается совершить действие.
Биологическое тело не может его выполнить.
Зато виртуальное — может.
Это своеобразный обход повреждённого участка системы.
И скорость здесь важнее, чем кажется
Можно дать человеку экран с меню:
«Кивок».
«Пожать плечами».
«Помахать рукой».
Потом заставить его каким-нибудь способом выбирать нужный пункт.
Технически жест получится.
Только естественного разговора уже не останется.
Мы ведь не думаем во время беседы:
— Сейчас я закончу слово, потом открою меню жестов и добавлю к фразе одно пожатие плечами.
Жест появляется вместе со словами.
Поэтому принципиально важно, что новая система декодирует оба намерения параллельно и в реальном времени.
В отдельных разговорных тестах один из участников достиг медианной точности 100% и по речи, и по жестам в трёх блоках.
Но радоваться цифре осторожно: словарь фраз и набор жестов пока были небольшими. Это доказательство принципа, а не готовый универсальный переводчик всего человеческого поведения.
Но направление уже хорошо видно
Первое поколение коммуникационных BCI решало задачу:
дать человеку способ что-нибудь сообщить.
Даже медленно набрать предложение глазами — уже огромное возвращение самостоятельности для человека, который иначе почти полностью зависит от окружающих.
Следующая цель значительно амбициознее:
вернуть не просто информацию, а самого человека в разговор.
С его голосом.
Темпом.
Интонацией.
Лицом.
Жестами.
И, возможно, в будущем — движением всего цифрового тела.
Разница примерно как между SMS и видеозвонком.
В обоих случаях информация передана.
Но ощущение присутствия совершенно разное.
Собственно, лицо они уже научились возвращать раньше
Предыдущие работы той же группы особенно интересны именно в этом контексте.
Исследователи уже декодировали не только слова, но и движения, необходимые для речи: положение губ, языка, челюсти и другие моторные элементы. На их основе цифровой аватар мог синхронизировать лицо с синтезированной речью.
То есть система постепенно собирается слоями.
Сначала текст.
Потом голос.
Потом лицо.
Теперь жесты верхней части тела.
Это уже напоминает не обычный интерфейс связи, а цифровую реконструкцию присутствия человека.
Следующий логичный вопрос: а зачем вообще ограничиваться аватаром?
Сигнал «я хочу поднять руку» после декодирования становится компьютерной командой.
А компьютерную команду необязательно отправлять в Unreal Engine.
Её можно отправить роборуке.
Экзоскелету.
Инвалидной коляске.
Домашней автоматике.
Манипулятору.
Другому физическому устройству.
И вот тут разные ветки нейротехнологий постепенно начинают сходиться.
Одни исследователи учат мозг управлять курсором.
Другие — роботизированной рукой.
Третьи стимулируют спинной мозг, чтобы восстановить движение собственного тела.
Четвёртые декодируют речь.
Теперь несколько каналов начинают объединяться.
В долгосрочной перспективе человеку может быть не нужен отдельный «BCI для текста» и другой «BCI для руки».
Нужен один интерфейс, который понимает намерения тела.
Сам мозг для этого удивительно удобен
Человек может не двигать рукой много лет.
Но нейронная активность, связанная с намерением движения, часто сохраняется.
Моторная система продолжает формировать команды, хотя физический путь к мышцам повреждён болезнью или травмой.
Получается довольно странная ситуация.
Программа всё ещё запускается.
Провод оборван.
BCI пытается подключиться до места обрыва и отправить команду другим маршрутом.
Именно поэтому нейропротезирование вообще возможно.
Мы не обязательно учим мозг новому искусственному языку с нуля.
Часто пытаемся расшифровать тот язык, на котором он уже десятилетиями разговаривал с собственным телом.
Правда, до бытового устройства ещё прилично
В нынешней системе используются имплантированные электроды.
Это операция на мозге.
Аппаратура пока соединена с внешними вычислительными устройствами проводами.
Участников — трое.
Полнотелый аватар проверяли у двоих.
Набор жестов ограничен.
Система индивидуально обучается под конкретного человека.
То есть это не продукт, который в понедельник появляется в магазине медицинской техники.
Сами исследователи называют работу proof of concept — доказательством того, что принцип вообще работает.
Следующий этап — полностью имплантируемая беспроводная система, пригодная для значительно более длительного использования.
Вот после этого разговор станет намного практичнее.
Ещё сложнее сделать систему действительно естественной
Человеческое тело обладает чудовищным количеством степеней свободы.
Пальцы.
Кисти.
Локти.
Плечи.
Туловище.
Голова.
Глаза.
Лицо.
А ещё мы двигаем всем этим одновременно.
Сегодняшний аватар воспроизводит ограниченный набор заранее определённых жестов.
Следующий большой скачок произойдёт, если система сможет декодировать не категорию:
«сделай жест №7»
а непрерывное движение.
Человек представил, как протягивает руку, поворачивает кисть и указывает на предмет — цифровое тело повторило именно эту траекторию.
Вот тогда слово «тело» перестанет быть красивой метафорой.
А потом появится ещё одна очень странная возможность
Цифровое тело не обязано полностью копировать биологическое.
У человека две руки.
Почему виртуальной системе обязательно иметь две?
Сегодня мысль выглядит несколько фантастической, но эксперименты с дополнительными роботизированными конечностями существуют давно. Мозг способен учиться работать с довольно необычными интерфейсами.
Если BCI перестанет просто восстанавливать потерянные функции и начнёт добавлять новые, граница между нейропротезом и расширением возможностей человека станет довольно мутной.
Сначала:
— Верните мне руку.
Потом:
— Хорошо, а можно ещё дрон управлять?
И в этот момент нейроинтерфейс превращается уже не только в медицинскую технологию.
При этом ИИ здесь вообще не декоративная надпись на коробке
Без машинного обучения эта система практически невозможна.
Электроды не получают из мозга аккуратный JSON:
gesture: thumbs_up
Они записывают сложную электрическую активность тысяч нейронов.
Причём сигнал немного меняется со временем, отличается между людьми и перекрывается между разными действиями.
Модели должны найти закономерность и в реальном времени решить, какое намерение стоит за текущим рисунком активности.
Чем больше каналов коммуникации мы захотим вернуть одновременно, тем сложнее станет декодирование.
И здесь медицина неожиданно оказывается в той же точке, что роботы, агенты и 6G из наших предыдущих материалов.
Всё упирается в системы, способные работать сразу с несколькими потоками данных и контекстом, а не решать одну аккуратно вырезанную задачу.
Именно за такими переходами от «ИИ умеет одну штуку» к связанным системам я слежу в GPT‑Лаборатории. Потому что сегодня эта архитектура появляется в маркетинге и автоматизациях, а завтра похожая логика управляет роботом или собирает из сигналов мозга цифровое тело.
Но самое важное здесь вообще не технология
Представьте человека, который прекрасно понимает шутку собеседника.
У него мгновенно возникает совершенно естественная реакция.
Улыбнуться.
Махнуть рукой.
Пожать плечами.
Ответить.
Только почти ничего из этого тело больше выполнить не может.
Старые коммуникационные системы возвращали содержание:
«Я понял шутку».
Новая цель — вернуть ещё и реакцию.
А это маленькая, но очень человеческая разница.
Мы привыкли оценивать интерфейс по скорости передачи информации. Сколько слов в минуту? Какая точность? Сколько команд распознано?
Но общение — не передача ZIP-архива между двумя компьютерами.
Мы постоянно выражаем отношение к словам всем телом.
И чем лучше нейроинтерфейсы научатся восстанавливать именно этот слой, тем меньше они будут выглядеть как медицинская клавиатура, подключённая к мозгу.
И тем больше — как второе тело, через которое человек снова способен присутствовать рядом с другими.
Сегодня оно живёт на экране.
Кивает.
Машет рукой.
Пожимает плечами.
Одновременно говорит.
Следующим шагом вполне может оказаться уже не аватар.
А физическая машина, которая получит ту же команду из мозга — и действительно протянет руку.