Свиток, который нельзя развернуть: как ИИ помогает прочитать обугленные тексты из Геркуланума
Представьте библиотеку, от которой остались не книги, а угли. Не пепел и не отдельные обрывки, а обугленные свитки, похожие на головешки из давно погасшего костра. Примерно так выглядят свитки из Геркуланума: в 79 году н. э. извержение Везувия обуглило их, но не уничтожило до конца. Часть текста внутри сохранилась — и остаётся недоступной, потому что физическое разворачивание такого свитка грозит повреждением или утратой текста. Папирус превратился в хрупкую угольную структуру, которая может рассыпаться от прикосновения.
Отсюда главный вопрос: можно ли прочитать то, что физически нельзя раскрыть? И где во всей этой истории настоящая роль искусственного интеллекта, а где — красивая формулировка для пресс-релиза?
Сначала не ИИ, а томограф
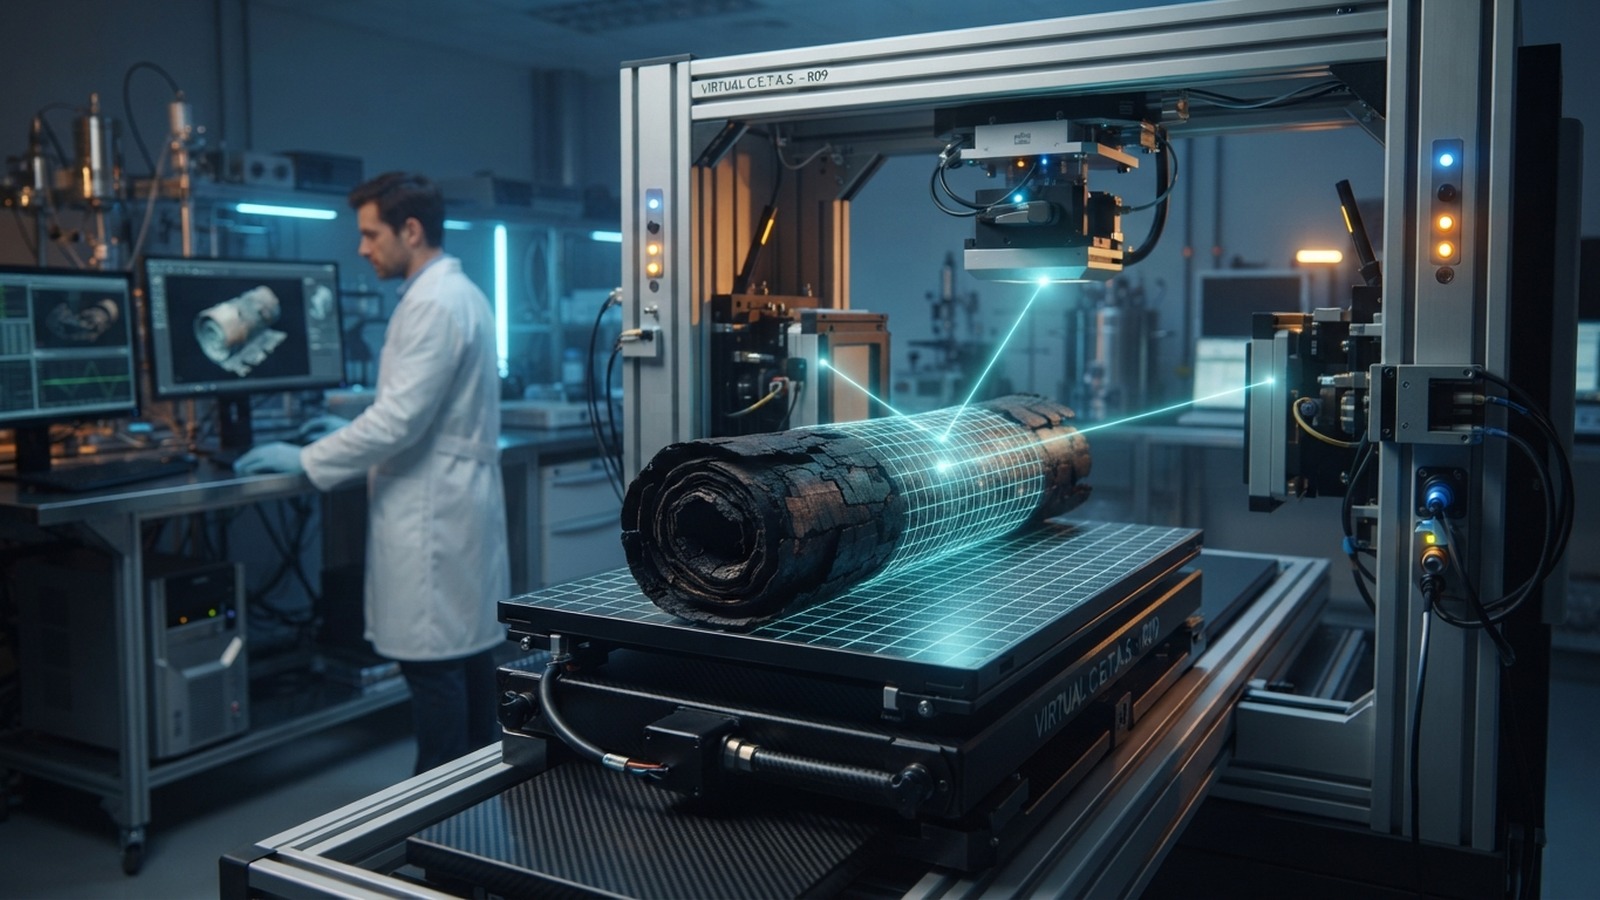
Первое, что нужно сказать прямо: свиток «читает» не нейросеть. Первый шаг — рентгеновская микротомография. Свиток целиком сканируют, получая трёхмерный набор данных: фактически объёмный рентгеновский снимок, где видны внутренние слои и структура свитка. Это ближе к компьютерной томографии в медицине, чем к сканеру текста. Аппарат видит структуру, но не понимает, что перед ним древний философский трактат.
На этом этапе никакого «искусственного интеллекта, который читает» ещё нет. Есть физика, подробная съёмка и огромный массив данных, с которым дальше нужно что-то делать. Именно поэтому разговор про ИИ в истории с геркуланумскими свитками стоит начинать не с алгоритмов, а с томографа — иначе получается, будто машина сама догадалась, что внутри угля спрятан текст.
Виртуальное разворачивание: геометрия, а не магия
Дальше начинается вычислительная часть. Из трёхмерных данных нужно найти слои папируса и «распрямить» их программно, сохранив связь каждой точки получившегося изображения с исходным объёмом. Это и называют виртуальным разворачиванием. Речь не о фотографии развёрнутого листа, а о восстановленной поверхности, которую построили по косвенным данным.
Сложность не в том, чтобы нажать кнопку «развернуть». Свиток деформирован, слои прилегают друг к другу вплотную. В препринте 2026 года по свитку PHerc. 1667 авторы указывают 31 виток и около 25 часов ручной разметки на каждый виток. Это данные конкретного проекта, а не универсальная норма, но масштаб они показывают неплохо: автоматика работает не сама по себе, а вместе с людьми, которые вручную размечают слои.
Проще всего представить спрессованный слоёный пирог, сжатый в кулаке. Пока он целый, видна только тёмная масса. Чтобы добраться до начинки, нужно сначала понять, где заканчивается один слой и начинается другой. Томограф даёт объём, алгоритмы помогают разобраться в геометрии, но с «начинкой» — самим текстом — всё ещё сложнее.
Чернила, которые почти не отличаются от бумаги
Отдельная проблема — чернила. В этих свитках и папирус, и чернила углеродные, поэтому на обычном рентгеновском изображении они могут быть почти неотличимы от основы. Задача примерно такая: прочитать надпись тёмно-серым по тёмно-серому внутри спрессованного комка.
Здесь и включается машинное обучение. Модель обучают на участках, где томографические данные сопоставлены с реальными фотографиями поверхности фрагментов: алгоритм видит, как выглядит известный текст в объёме, и учится искать похожие слабые признаки на незнакомых участках. Ранние модели распознавали далеко не всё и не идеально. Это инструмент, а не волшебная лупа: он выделяет вероятные следы чернил, но не понимает буквы и уж точно не читает смысл.
Восемь папирологов и слово «препринт»
Самая важная часть истории — та, которую обычно опускают. Машинное предположение о буквах не является окончательной расшифровкой. Чтение принимали только тогда, когда геометрия восстановленной поверхности соответствовала слою папируса, формы букв повторялись при разных вариантах обработки, а специалисты подтверждали результат независимо друг от друга или приходили к согласию. Для PHerc. 1667 над транскрипцией работали восемь папирологов — именно они проверяли, какие буквы действительно видны.
И ещё одна оговорка, без которой материал превращается в пересказ пресс-релиза. Результаты 2026 года описаны в препринте на arXiv, поданном в июне 2026 года, и журнальное рецензирование они ещё не прошли. Это не отменяет работу исследователей, но меняет статус заявления: перед нами описание метода и результата от самих авторов, а не статья в рецензируемом журнале.
Три свитка, три разных истории
PHerc. Paris 4. В 2023 году участники Vesuvius Challenge извлекли из этого свитка несколько колонок ранее не прочитанного текста — результат ранний и частичный. В 2026 году улучшенная томография позволила увидеть чернила непосредственно в трёхмерных данных, и полученная сегментация совпала с тем, что было прочитано раньше. Это не новая сенсация, а независимая проверка уже сделанного чтения.
PHerc. 1667. В июне 2026 года проект объявил о полном виртуальном разворачивании сохранившейся части свитка без физического раскрытия. Название и автор произведения при этом не установлены. В препринте говорится о стоическом контексте: в тексте, по чтению авторов, упоминается Аристокреон, философ-стоик, которого связывают с Хрисиппом. Но это вероятная интерпретация, а не установленное авторство или название трактата, и разница здесь принципиальная.
PHerc. 139. А вот здесь есть конкретный филологический результат: прочитано название и атрибуция — Филодем, «О богах», книга 8. Филодем был древним философом-эпикурейцем, и найденное название расширяет известные сведения о его трактате. За технической работой виден нормальный гуманитарный итог.
Где заканчиваются возможности метода
Соблазн сказать «теперь можно прочитать все свитки» велик, но он неверен. Авторы препринта прямо отмечают зависимость результата от качества скана, сохранности свитка, деформаций, разделимости слоёв и различимости чернил. Часть библиотеки может остаться недоступной: метод не универсален.
К этому стоит добавить разницу между типами утверждений, которую в таких историях постоянно размывают. Подтверждённый факт — обугливание свитков в 79 году и сама возможность рентгеновской томографии. Заявление проекта — объявление о полном виртуальном разворачивании PHerc. 1667. Препринт — описание метода и результатов, ещё не прошедшее журнальное рецензирование. И только потом идут интерпретации вроде «стоического контекста». Для читателя это важнее очередной красивой цифры.
Что здесь на самом деле произошло
ИИ не заменил ни археологию, ни томографию, ни филологию. Он встроился в цепочку как инструмент, который помогает увидеть слабые сигналы там, где человеческий глаз бессилен. Томограф снимает объём, алгоритмы помогают распутать геометрию и найти следы чернил, папирологи проверяют буквы и смысл. Уберите любое звено — и конструкция рассыпается.
На мой взгляд, главный результат здесь не в том, что «нейросеть прочитала древность». Главное — исследователи научились получать данные из объекта, который нельзя открыть, и проверять эти данные людьми, а не принимать на веру. Это не воскрешение библиотеки и не гарантия, что завтра прочтут всё остальное. Это аккуратный способ заглянуть внутрь, не разрушая, — и, если повезёт, узнать ещё пару имён и названий, которые иначе остались бы погребены в угле.