Телефон переводит жесты в текст. Почему это сложнее распознавания речи
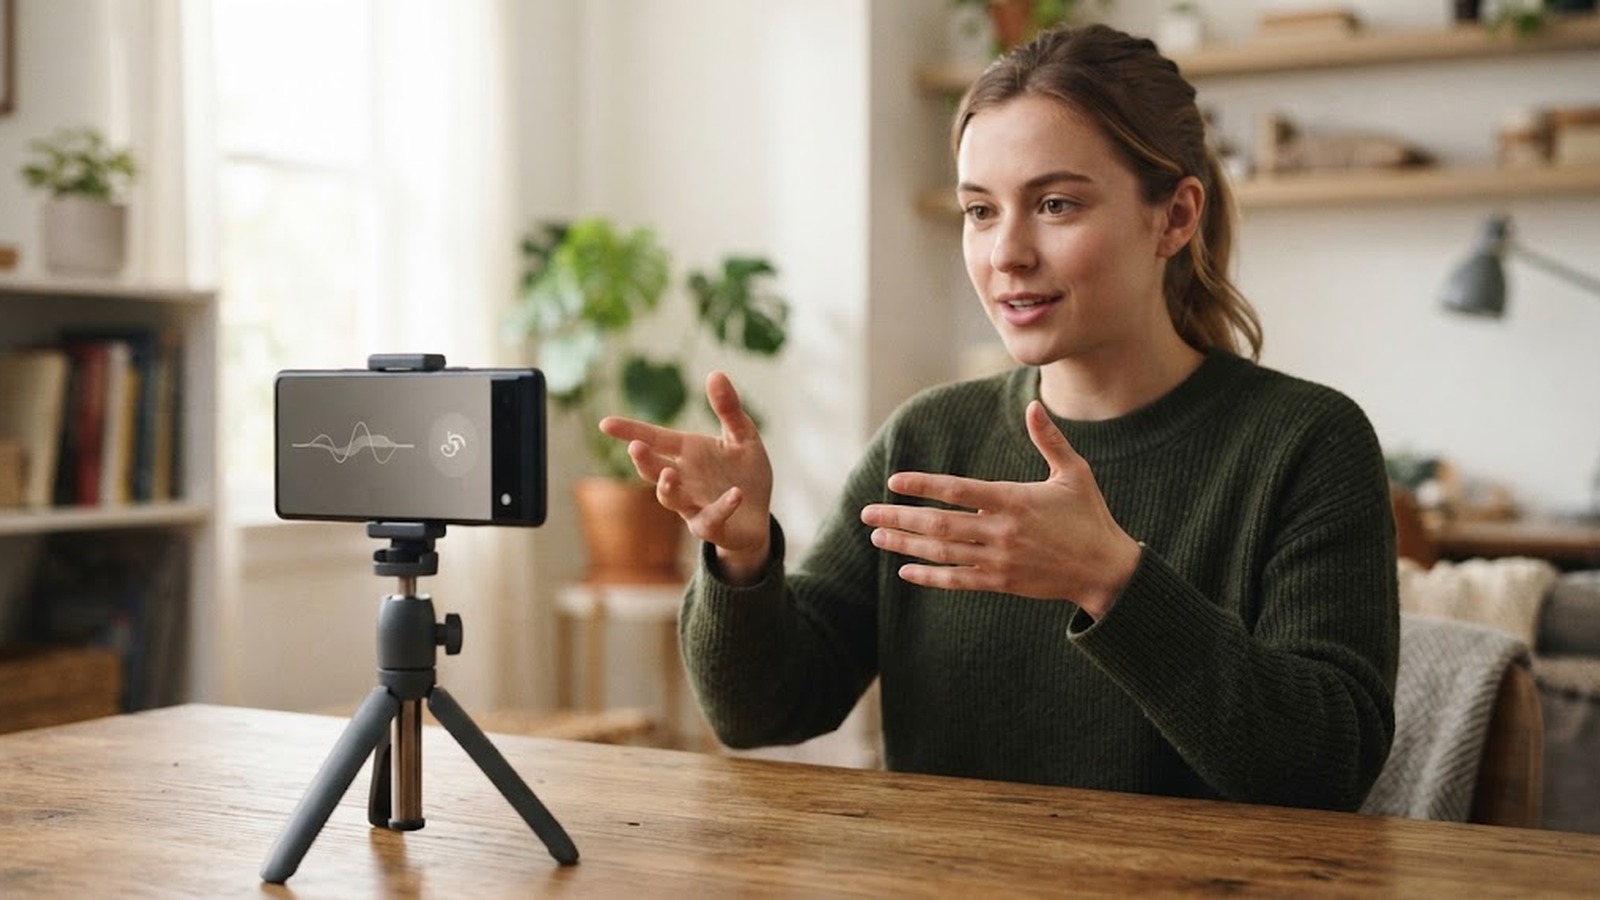
Человек садится перед смартфоном, показывает несколько жестов — и в поле ввода появляется английская фраза. Не набор букв и не подсказка «возможно, вы имели в виду», а готовый текст, который можно отправить в мессенджере или вставить в поисковую строку. 12 августа 2026 года Google DeepMind представила систему SL2T, которая переводит американский жестовый язык в письменный английский. На практике это ещё один способ ввода рядом с голосом и клавиатурой, только камера смотрит не на палец, а на руки, лицо и корпус.
Сравнение с распознаванием речи напрашивается: там тоже человек говорит, а телефон выдаёт текст. Но аналогия ломается почти сразу. Распознавание речи преобразует последовательность звуков в слова того же языка — пусть с ошибками, но по правилам той же системы. SL2T переводит с одного языка на другой, и на входе у неё не звук, а движение в пространстве. В этом и главный интерес проекта: он показывает, насколько машинный перевод сложнее распознавания сигнала.
Жест — это не слово, произнесённое руками
Американский жестовый язык — самостоятельный естественный язык со своей грамматикой и лексикой, а не калька английского, переложенная на руки. Это отдельно подчёркивает Gallaudet University, профильный университет для глухих и слабослышащих. Поэтому схема «каждому жесту — английское слово» не работает: порядок элементов в высказывании другой, часть смысла вообще не привязана к отдельному знаку и строится через пространство и последовательность.
Смысл в жестовом языке несут не только кисти. Работают форма и ориентация ладони, характер движения, положение рук относительно тела, наклон корпуса и головы, направление взгляда и мимика. Неручные маркеры — поднятая бровь, кивок, покачивание головы — могут обозначать вопрос, отрицание или другую грамматическую конструкцию, а не эмоциональный оттенок. Само пространство перед говорящим используется как рабочая зона: в нём размещают участников высказывания и показывают отношения между ними.
Из этого следует неприятная для инженеров вещь. Задача не в том, чтобы распознать побольше жестов и сложить их в строку. Нужно восстановить смысл, который распределён по рукам, лицу, телу и пустой на первый взгляд области воздуха между ними. Поэтому SL2T корректнее называть системой машинного перевода, а не «словарём жестов» с камерой.
Что видит телефон
На устройстве MediaPipe Holistic извлекает из картинки 130 двумерных опорных точек лица, тела и рук. Дальше исходное видео отбрасывается, а на сервер уходит последовательность координат. Этот момент стоит проговорить точно, потому что вокруг него легко уйти в любую из двух крайностей: запись с камеры в Google не отправляется, но и полностью автономной работы на телефоне нет — перевод считается на сервере. Согласно документации, координаты, видео и результаты перевода не сохраняются.
Последовательность движений обрабатывает трансформерная модель: она получает координаты и порождает английский текст авторегрессионно, слово за словом. Промежуточные «глоссы» — условные словесные метки отдельных знаков — в системе не используются. Разработчики объясняют отказ от них тем, что глоссы плохо передают одновременные неручные маркеры и пространственные конструкции: пока вы записываете один знак одним словом, часть смысла выпадает из записи.
По данным Google, модель обучалась более чем на 100 000 часов материала более чем по 50 жестовым языкам, и примерно четверть этих данных относилась к ASL. Здесь нужна аккуратность: объём обучающего корпуса и число поддерживаемых языков — разные вещи. Первая пользовательская функция переводит только американский жестовый язык в английский текст. Формулировка «телефон понимает более 50 жестовых языков» была бы неправдой, даже если обучающие данные действительно были многоязычными.
Что можно включить уже сейчас
Функция живёт в двух местах. В Gboard это режим Sign-to-text: человек включает его и может набирать ASL в любое приложение, которое принимает ввод с клавиатуры — сообщение, заметку, поисковый запрос, команду Gemini. Требования конкретные: Pixel 11, актуальная версия Gboard, язык клавиатуры en-US или en-CA, а камера должна видеть лицо, руки и верхнюю часть тела. В Live Transcribe сценарий другой — короткий обмен репликами, например заказ кофе или разговор с сотрудником магазина. Полученный текст можно проверить, показать собеседнику или озвучить через динамик.
В рамках дорелизного внешнего дневникового исследования участники искали адреса и товары, переписывались, публиковали посты в соцсетях, делали заметки, отправляли запросы к Gemini и вели короткие личные разговоры. Особенно положительно они оценили короткие запросы и снижение усталости от набора текста. Оговорка обязательна: сообщения о том, что жестами быстрее, чем печатать, зависят от владения ASL, грамотности в английском, длины сообщения и того, сколько времени уйдёт на исправление ошибок.
За проектом стоят конкретные люди. DeepMind называет инициатором концепции Сэма Сепы, глухого сотрудника Google, который также основал консультативный комитет AISLAC. Гэри Бем, глухой пользователь ASL, возглавляет Center on Access Technology при National Technical Institute for the Deaf — подразделении Rochester Institute of Technology. Его центр собирал данные и около четырёх лет помогал тестировать технологию. Продукт про сообщество глухих делался не только снаружи этого сообщества.
При этом не стоит смешивать всех в одну категорию. Глухие и слабослышащие — не однородная группа, и далеко не все из них владеют именно американским жестовым языком: кто-то использует другие жестовые языки, кто-то устную речь, кто-то комбинацию способов общения.
Где система спотыкается
Первая группа ограничений — техническая. Качество падает при слабом или контровом свете, при недостаточном контрасте между руками и одеждой, если человек вышел из кадра или камера стоит под необычным углом. Двумерные точки не дают глубины, поэтому система не всегда уверенно различает касание и движение руки над поверхностью. Она не отслеживает язык во рту и не понимает предметное окружение — то есть часть контекста, на который человек опирается автоматически, для модели просто не существует.
Вторая группа сложнее. Хуже переводятся пространственные конструкции, классификаторные предикаты, региональные варианты, многозначные знаки и значения, которые выражаются преимущественно лицом. В совместном отчёте Google DeepMind и AISLAC приведены показательные ошибки: код штата Мэн 207 иногда превращался в 2007, английское prey распознавалось как grey, а конструкция с «когтями» исчезала из перевода целиком. Отдельно зафиксирован «призрачный текст» — генерация слов во время паузы или при появлении в кадре второго человека. К релизу частоту таких сбоев снизили, но не устранили.
Цифры проекта тоже требуют перевода на человеческий язык. В отчёте для SL2T 1.0 указаны 25 BLEU и 70 BLEURT на zero-shot-разделе FLEURS-ASL, 67 BLEU и 85 BLEURT на наборе PRESTO-ASL и 64% точного совпадения при распознавании пальцевой азбуки в FSboard. BLEU и BLEURT сравнивают выход системы с эталонными переводами; они не означают «процент правильно понятых слов» и тем более не являются универсальной точностью в бытовом смысле. Цифра 64% на FSboard относится к конкретной задаче — распознаванию дактилологии, а не к переводу связной речи целиком.
Чего SL2T не делает
Google позиционирует систему как инструмент для черновика: полученный текст пользователь должен проверить и при необходимости исправить. Осторожность здесь не юридическая формальность. Модель выдаёт наиболее вероятный текстовый вариант и не умеет переспросить, что имелось в виду, — а профессиональный переводчик умеет.
Список исключений в отчёте выглядит жёстко: медицинские консультации, суды и полицейские допросы, формальное образование, собеседования и кадровые решения, ответственные государственные процедуры. Причина понятна. Ошибка в дружеской переписке — неприятность, которую легко исправить следующим сообщением. Ошибка в разговоре с врачом или на допросе — последствия для человека, а не для метрики.
И ещё одно ограничение, которое легко упустить: перевод идёт только в одну сторону. SL2T превращает ASL в письменный английский, но не переводит английскую речь или текст обратно в жесты. Полноценный двусторонний диалог с человеком, который не знает жестового языка, такая система не обеспечивает — она закрывает половину задачи.
Что это меняет практически
Главный сдвиг не в том, что «телефон научился понимать жесты». Сдвиг в появлении ещё одного способа ввода текста без клавиатуры — для людей, которым ASL ближе и привычнее, чем набор по буквам. Это может ускорять короткие бытовые сценарии: сообщение, поиск, заметку, разговор на кассе. Но доступность ограничена сразу по нескольким осям: конкретная модель телефона, конкретный жестовый язык, конкретный письменный язык, конкретные приложения и нормальные условия съёмки.
Поэтому обучение на материале более 50 жестовых языков не стоит читать как обещание скорой поддержки каждого из них. Google говорит о будущей поддержке других устройств и языков, но сроков не называет, и считать их доступными уже сейчас оснований нет. Русского жестового языка среди работающих функций тоже нет, как нет и международного жеста. Первый запуск — только ASL в английский текст, всё остальное пока относится к исследовательской базе.
Если хочется разбираться в таких вещах не по заголовкам, а по конкретным сценариям применения нейросетей, у GPT-Лаборатории есть Telegram-канал: https://t.me/jopotology. SL2T там интересна не сама по себе, а как пример того, где ИИ берёт на себя узкую функцию общения и где пока вынужден остановиться.
Самое честное чтение этого релиза такое: перед нами заметный шаг, но не «переводчик в кармане» для всех. Система показывает, насколько сложным остаётся язык, в котором смысл живёт не в отдельных знаках, а в сочетании рук, лица, тела и пространства. Распознать движение — полдела. Перевести смысл, который распределён по всему этому, — задача другого порядка, и SL2T пока решает её в режиме аккуратного черновика: полезного в простых ситуациях и честно ограниченного там, где цена ошибки слишком высока.