Робот может повторить движение человека — и всё равно не решить задачу
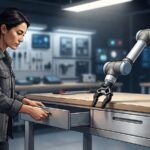
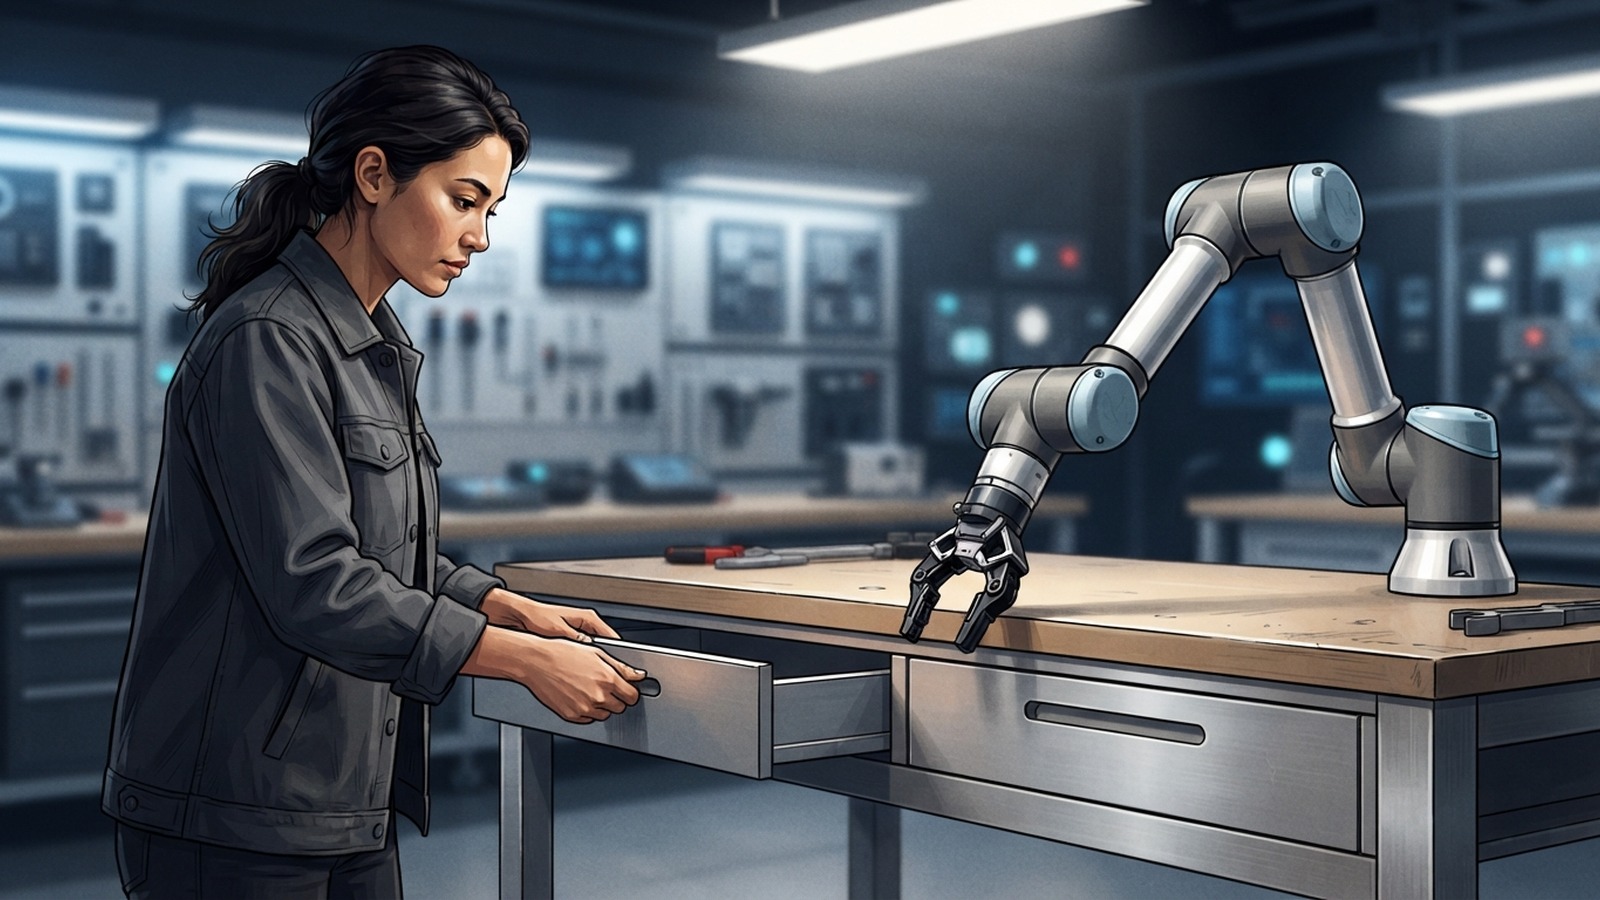
Человек берётся за ручку ящика и тянет на себя. Ящик выезжает по направляющим. Робот смотрит, затем повторяет: подводит манипулятор, захватывает, тянет — и тоже открывает. Движение почти идеальное, если не придираться к скорости. А потом перед ним ставят другой ящик того же типа — сдвинутый вбок и с ручкой не по центру. Манипулятор уверенно тянется в пустоту.
Дело не в плохой моторике. Это короткая иллюстрация границы между копированием движения и пониманием задачи: робот может безупречно воспроизвести показанное и провалиться на первом же изменении обстановки, потому что выучил не «открыть ящик», а конкретную последовательность суставных углов в конкретной сцене. Чем аккуратнее исполнена такая последовательность, тем убедительнее выглядит результат — и тем меньше в нём ума.
Демонстрация — это не всегда траектория
Обучение по демонстрациям, learning from demonstration, — не один приём, а целый класс методов. Робот строит по примерам правило выбора действий, и дальше всё зависит от того, что именно система вытаскивает из показа. Демонстрация может превратиться в прямое соответствие «состояние — действие», в динамическую модель, в набор заученных движений или в материал для планировщика, который будет искать путь самостоятельно. Это различие важнее, чем кажется: от него зависит, получится ли у машины второй ящик.
Сводить imitation learning к «робот запомнил, как двигалась рука человека» — примерно то же, что учить повара повторять угол наклона ножа. Показать, как резать лук, можно по-разному: передать результат и способ его достижения или только внешнюю форму, которую разрушит другая доска, другой нож и другая луковица.
Почему точное повторение ломается от сдвинутого ящика
Проблема здесь не в метафорах, а в механике обучения. В последовательной задаче каждое действие робота меняет то, что он увидит следующим. Немного отклонился — попал в ситуацию, которой не было в обучающих данных. Там его никто не поправлял, следующее действие оказалось чуть хуже, отклонение выросло, и дальше ошибка накапливается сама. Это называют сдвигом распределения и накоплением ошибок.
Отсюда следует неприятный вывод: ещё десяток показов той же безошибочной траектории такую проблему не решает. В идеальных демонстрациях просто нет тех состояний, в которые робот попадает из-за собственных ошибок. Именно поэтому в 2011 году появился алгоритм DAgger — он предлагает доучивать систему на примерах из состояний, куда обучаемый робот заходит сам по ходу выполнения. Не «смотрите ещё раз, как правильно», а «давайте разберём, что делать там, куда вы уже забрались».
Хрупкость такого поведения — не мелкий баг, который исправят следующей версией прошивки. Это прямое следствие того, чему систему учили. Мир не обязан повторять демонстрацию один в один.
По движению не всегда видно цель
Даже если робот идеально воспроизвёл траекторию, по ней самой нельзя однозначно сказать, что он считал целью. В исследованиях по inverse reinforcement learning система пытается восстановить по наблюдаемому поведению функцию вознаграждения — формальное описание того, какой результат предпочтителен. И здесь есть принципиальная сложность: одна и та же демонстрируемая политика может быть оптимальной для разных функций вознаграждения. Проще говоря, одинаковое движение подходит под несколько разных намерений.
С ящиком это видно наглядно. Человек тянет ручку на себя — но что здесь существенно? Что ящик открылся? Что он открылся именно до конца? Что рука человека вообще побывала в этой точке? Для робота, который выучил траекторию, все эти вопросы сливаются в один, потому что ответ хранится не в цели, а в координатах.
В работе 2013 года демонстрации использовали иначе: как опыт, ускоряющий планирование. Открытие ящика или двери там разложено на две разные подзадачи. Сначала нужно свободно подвести манипулятор к подходящей точке контакта. Затем двигаться с учётом механического ограничения объекта: ящик выезжает вдоль направляющих, дверь вращается вокруг петель, и никакая траектория этого не отменяет. Робот PR2 в тех экспериментах открывал несколько различных шарнирных и выдвижных объектов — не потому, что заучил универсальное движение, а потому, что демонстрация служила материалом для планирования, а не жёстким сценарием.
С бытовыми задачами та же история. Показывают роботу «взять кружку и поставить в шкаф». Что считать успехом: кружку внутри шкафа, освобождённый стол или сохранённую ориентацию кружки, чтобы из неё не вылилось? Один показ эти варианты надёжно не различает. Нужны дополнительные примеры, словесная команда или заранее заданный критерий успеха — то, что сообщает системе, ради чего всё делалось.
Отдельный случай — неожиданная коробка на пути руки. Робот с заранее записанной траекторией спокойно продолжит движение по старому пути. Политика с визуальной обратной связью в принципе способна заметить изменение и скорректировать следующие действия, но это зависит от того, на каких ситуациях её обучали и сработает ли коррекция в конкретном случае. И даже удачный объезд коробки сам по себе доказывает адаптивное управление, а не распознавание конечной цели: машина может ловко реагировать на помеху, ни на секунду не понимая, зачем ей вообще этот ящик.
Три уровня: повторить, понять, спланировать
Чтобы не путаться в очередной демонстрации «умного робота», полезно держать в голове три разных уровня, которые часто смешивают в одно слово «понимает».
- Воспроизведение движения. Политика «увидел — повторил». Самая хрупкая конструкция: работает, пока сцена совпадает с показанной.
- Распознавание желаемого результата. Появляется критерий успеха, по которому можно проверить, достигнута ли цель, и отличить правильное завершение от просто похожего движения.
- Планирование нового пути. Система сама выбирает другую последовательность действий, если прежняя не ведёт к результату: обходит препятствие, иначе берёт ручку, подходит с другой стороны.
Эти уровни не выстроены в обязательную лестницу, по которой проходит каждая система. Кто-то прыгает сразу на третий, кто-то остаётся на первом и прекрасно смотрится в рекламном ролике. Но различать их стоит, потому что внешний успех на видео одинаково хорошо выглядит во всех трёх случаях.
Что уже получается у исследователей — и что это не доказывает
Справедливости ради, кое-что действительно получается, и не только в постановочных роликах. В работе 2017 года по one-shot visual imitation робот после одной новой визуальной демонстрации адаптировался к вариантам задач с толканием и размещением предметов, включая помещение нового предмета в новый контейнер. Звучит как прорыв, и оговорка здесь принципиальная: способность появилась после метаобучения на множестве предыдущих задач. Один показ задавал новую задачу, а не создавал всю систему управления с нуля.
Diffusion Policy 2023 года показывает другой механизм. Политика регулярно получает новые изображения, предсказывает не одно движение, а последовательность действий и перепланирует её по мере исполнения — так называемое управление с уходящим горизонтом. Метод проверяли на 12 задачах из четырёх наборов тестов, авторы сообщили о среднем улучшении относительно выбранных базовых методов на 46,9%. Цифра честная, но привязана к конкретному стенду, конкретным объектам и конкретному распределению тестов. Переносить её на надёжность бытового робота на кухне — отдельное упражнение, к результатам исследования не относящееся.
RT-2 — пример другого рода. Это vision-language-action-модель, обученная совместно на роботизированных траекториях и крупномасштабных визуально-языковых данных. В экспериментах она лучше базовых моделей справлялась с командами, где требовалось связать словесное описание с новым объектом и его семантическими признаками. Это шаг от воспроизведения знакомого движения к выбору действия по описанию результата, но не доказательство того, что система понимает физический мир так, как его понимает человек.
С термином «модель мира» тоже стоит обращаться аккуратнее. Утверждение, что перенос навыка обязательно требует явной предсказательной модели, слишком сильное. Адаптация возможна разными путями: реактивная политика с постоянной обратной связью, метаобучение на множестве задач, восстановление цели, семантическое предобучение, отдельный планировщик. Минимально нужны сведения о текущей ситуации, критерий успеха и механизм выбора или коррекции действий. Всё остальное — вопрос архитектуры, а не обязательный пропуск в клуб.
Проверка не в повторении
Гуманоидная форма, аккуратные пальцы и плавная мимика создают сильное впечатление, но сами по себе ничего не говорят о том, что система понимает задачу. Физический облик робота и принцип его обучения — разные вещи, и путать их легко именно потому, что человекоподобный корпус вызывает доверие раньше, чем появляется повод. На мой взгляд, это и есть главная ловушка нынешнего этапа: технику судят по внешнему сходству с человеком, а не по поведению в незнакомой обстановке.
Настоящая проверка выглядит скучно. Другая ручка. Другая высота. Сдвинутый ящик. Коробка, которой не было в демонстрации. Задача, где важен не путь руки, а результат — и где к результату ведёт несколько дорог. Если робот справляется только с тем, что уже видел, он выучил движение, а не задачу. И сколько бы изящно это движение ни выглядело, открывать им новый ящик он не умеет.