Представьте бизнес-план.
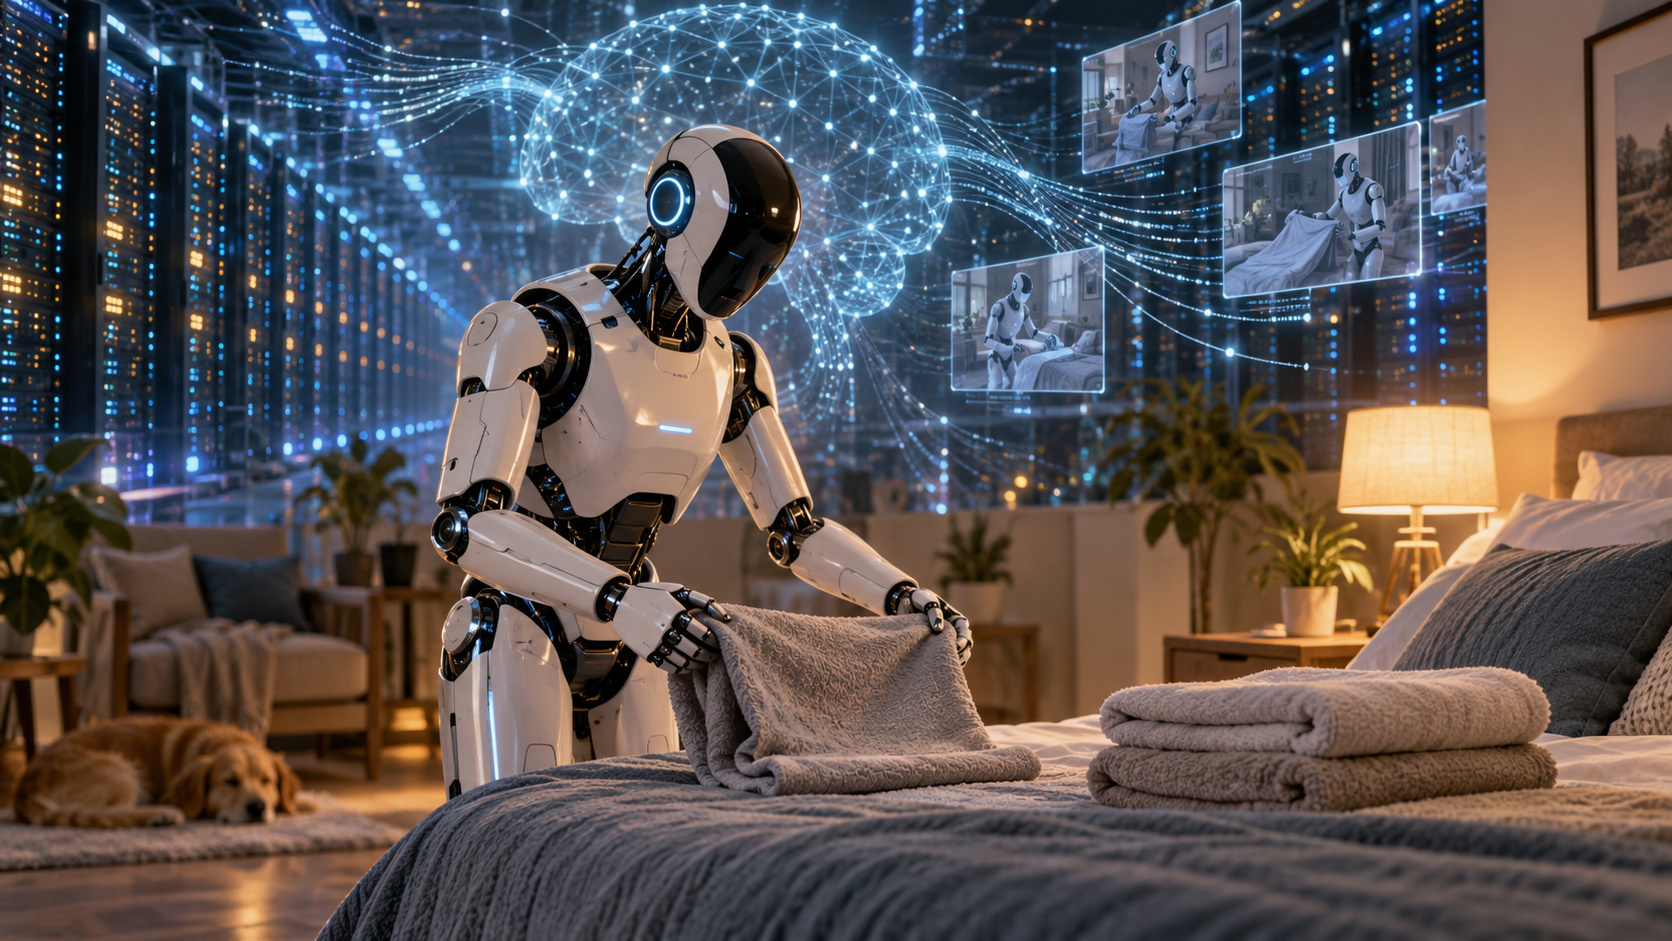
Нам нужен робот, который приходит домой и делает три вещи:
убирает гостиную;
складывает полотенца;
застилает кровать.
Звучит как задача для хорошего механика, нескольких камер и пары лет программирования.
А теперь бюджет.
Компания Figure подписывает соглашение на 3,5 миллиарда долларов вычислительных мощностей.
В перспективе — больше шести миллиардов.
Потенциально — до ста тысяч новейших GPU NVIDIA.
И всё это не ради очередной версии ChatGPT.
Ради роботов, которые должны научиться жить в нашем физическом мире.
Если кажется, что здесь кто-то слегка переборщил с железом, то нет.
Проблема просто оказалась намного тяжелее, чем выглядела.
Человеку достаточно один раз показать кровать
Допустим, вы умеете заправлять кровать дома.
Потом приехали в гостиницу.
Кровать другая.
Матрас выше.
Одеяло тяжелее.
Подушки лежат иначе.
Тумбочка мешает подойти с одной стороны.
Но никто не проводит вам четырёхчасовое дополнительное обучение.
Вы просто смотрите на новую кровать и делаете примерно то же самое.
Человеческий мозг умеет выделять общее правило:
вот кровать, вот простыня, вот одеяло — понятно, что делать.
Для робота долгое время всё выглядело совсем иначе.
Его научили работать с этой кроватью.
В этой комнате.
При этом освещении.
С этими предметами.
Переставили стул — и уверенность машины резко закончилась.
Именно поэтому красивые демонстрации роботов часто снимались в очень тщательно подготовленной среде.
Мир подстраивали под робота.
Figure хочет сделать наоборот.
Робот должен подстраиваться под мир.
В сентябре они привезли одного и того же робота в 30 разных домов
Новая система называется Helix 2.5.
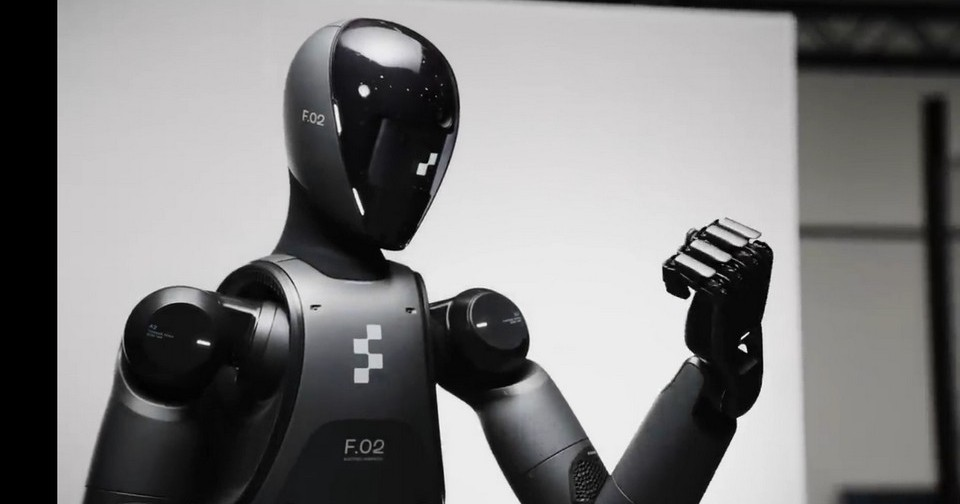
Компания обучила её на огромном массиве человеческого поведения, а потом дала три бытовые задачи:
убирать гостиные;
складывать полотенца;
застилать кровати.
После этого робота повезли по тридцати реальным домам в районе Сан-Франциско.
Никакого предварительного сканирования квартиры.
Никакого сбора данных именно в этом доме.
Никакого отдельного дообучения.
Новая мебель.
Новые кровати.
Новые комнаты.
Новые полотенца.
И робот должен был сразу работать.
Не идеально.
Но работать.
Для Physical AI это довольно серьёзный переход.
Потому что настоящая универсальность начинается не с того, что робот один раз красиво сложил полотенце перед камерой.
Она начинается с вопроса:
а если полотенце другое?
Без предварительного обучения результат был почти печальным
Figure провела показательный эксперимент.
Две одинаковые системы получили одинаковое количество данных для конкретной задачи.
Но одна начинала обучение почти с нуля.
Вторая сначала прошла большое предварительное обучение на массиве человеческого поведения Index.
На незнакомых домах первая успешно завершала задачу примерно в 9% случаев.
Вторая — в 56%.
Архитектура та же.
Конкретная задача та же.
Разница — огромный опыт, полученный заранее.
Знакомая история.
Именно так когда-то изменились языковые модели.
Сначала программу учили отдельно каждой задаче.
Потом выяснилось, что гораздо эффективнее сначала показать модели огромную часть человеческого текста, а уже после этого немного специализировать.
Теперь робототехника пытается повторить тот же трюк.
Только вместо интернета ей нужен физический мир.
А физический мир заметно тяжелее текста
Текст довольно удобный.
Вот токен.
Следующий токен.
Ещё один.
Последовательность дискретная.
Её можно хранить на диске.
Копировать.
Перемешивать.
Загружать миллиардами.
С телом всё неприятнее.
Робот одновременно получает изображение с камер.
Сигналы суставов.
Положение рук.
Угол каждого пальца.
Данные прикосновения.
Собственную позу.
Состояние равновесия.
И ещё должен решить, куда переместить десятки приводов через несколько миллисекунд.
Причём эти движения связаны.
Чтобы поднять коробку, недостаточно правильно согнуть пальцы.
Нужно подойти.
Повернуться.
Расположить корпус.
Перенести вес.
Протянуть руку.
Не потерять равновесие.
Схватить предмет.
Удержать его.
Потом куда-то понести.
Одно человеческое действие раскладывается на огромную последовательность непрерывных решений.
И ошибка уже не просто неправильное слово
Языковая модель написала:
«Париж — столица Германии».
Плохо.
Удалили сообщение.
Робот ошибся в координате руки на пятнадцать сантиметров.
Разбил чашку.
Ошибся в силе захвата.
Раздавил предмет.
Не заметил человека.
Уже совсем другой уровень проблемы.
Физический ИИ обязан не только понимать задачу.
Он должен постоянно связывать понимание с реальностью.
Посмотреть.
Предсказать.
Действовать.
Получить новый результат.
Снова посмотреть.
Исправить движение.
И повторять этот цикл много раз в секунду.
Поэтому модель робота — не просто «ChatGPT с ногами».
Ноги как раз оказались одной из наиболее дорогих частей интеллекта.
Раньше роботов программировали почти вручную
Классический промышленный робот живёт в прекрасном мире.
Деталь приезжает всегда в одну точку.
Конвейер движется с известной скоростью.
Манипулятор повторяет одну траекторию.
Людей желательно вообще убрать за ограждение.
В этих условиях программировать машину удобно.
Поднять руку сюда.
Повернуть сустав на такой угол.
Закрыть захват.
Переместить сюда.
Повторить сто тысяч раз.
Именно поэтому промышленная робототехника работает десятилетиями.
Но поставьте тот же подход в квартиру.
Одна кружка стоит ближе.
Вторая дальше.
Третья вообще лежит на боку.
Ребёнок оставил игрушку на проходе.
Кошка решила, что именно сейчас ей надо пройти между ног робота.
Человек изменил положение стула.
Жёстко запрограммировать все варианты невозможно.
Машине нужно не исполнять сценарий.
Ей приходится понимать ситуацию.
Figure поэтому обучает сразу всё тело
Ещё недавно многие роботизированные системы дробили задачу.
Отдельная модель видит мир.
Другая планирует.
Третья управляет руками.
Четвёртая отвечает за ходьбу.
Helix 02 пошла в другую сторону.
Одна нейронная система получает изображения, прикосновения и информацию о положении тела — и напрямую управляет всеми актуаторами.
Ногами.
Туловищем.
Руками.
Пальцами.
В январе Figure показала четырёхминутную автономную работу на кухне: робот сам ходил между посудомоечной машиной и шкафами, доставал предметы, переносил их и сохранял равновесие без ручного переключения между отдельными режимами.
Затем роботы начали убирать комнаты и вместе застилать кровать.
Очень бытовое видео.
Под ним — огромная вычислительная задача.
Но откуда взять столько физического опыта?
У ChatGPT был интернет.
У робота интернета нет.
На YouTube лежат миллиарды часов человеческого видео, но обычное видео далеко не всегда говорит машине, что именно происходило с телом человека.
Каким было усилие в пальцах?
Куда смотрел человек?
Что именно он почувствовал?
Почему слегка изменил хват?
Роботизированных демонстраций ещё меньше.
Первая версия Helix обучалась примерно на 500 часах телоуправляемых действий.
Для робота это много.
Для современной foundation model — почти ничего.
Figure решила масштабировать сбор данных примерно тем же способом, каким когда-то масштабировали обучение языковых моделей.
Компания создала систему Index.
Люди выполняют обычные бытовые действия и собирают данные человеческого поведения, которые затем используются для предварительного обучения роботов.
К сентябрю Figure заявляет уже примерно 35 минут нового человеческого опыта каждую секунду.
То есть за один реальный час система получает больше двух тысяч минут новых данных.
За сутки — уже десятки тысяч часов.
Физический интернет начинают строить вручную.
И тут появились те самые миллиарды
3 сентября Figure объявила соглашение с компанией Nscale.
Начальный объём — 3,5 миллиарда долларов вычислений.
В дальнейшем договор может увеличиться более чем до шести миллиардов.
В инфраструктуре потенциально предполагается до 100 тысяч GPU NVIDIA Vera Rubin.
Развёртывание первой партии намечено со второй половины 2027 года в Техасе.
И это очень важная цифра.
Робототехника долго считалась сравнительно небольшой отраслью рядом с генеративным ИИ.
Теперь один производитель гуманоидов начинает заключать контракты на вычисления масштаба крупных AI-лабораторий.
То есть Physical AI входит в ту же гонку:
больше модели → больше данных → больше вычислений → больше возможностей.
Figure прямо говорит, что сейчас её ограничивают прежде всего две вещи:
данные;
compute.
Не моторы.
Не красивые металлические корпуса.
Именно интеллект.
Но зачем GPU роботу, если сам робот маленький?
Здесь легко перепутать обучение и работу.
Когда готовый Figure ходит по комнате, он не тащит за собой сто тысяч видеокарт.
Большая вычислительная фабрика нужна прежде всего для обучения.
Представим один час собранного человеческого опыта.
Видео.
Движения.
Положение объектов.
Траектории.
Действия рук.
Контекст.
Чтобы модель научилась извлекать из этого общую закономерность, данные нужно много раз прогнать через огромную нейронную сеть.
Потом взять ещё миллиард примеров.
Повторить.
Проверить.
Сравнить версии.
Обучить следующую модель.
Попробовать другой размер.
Другие данные.
Другую архитектуру.
Чем универсальнее хотят сделать робота, тем больше разнообразия нужно показать заранее.
В итоге робот в квартире небольшой.
Зато его «детство» проходит в дата-центре стоимостью миллиарды.
Человек устроен ровно наоборот
Ребёнку не требуется сто тысяч GPU.
Зато обучение занимает лет двадцать.
Первые месяцы он вообще не умеет удерживать голову.
Потом учится переворачиваться.
Ползать.
Ходить.
Хватать предметы.
Понимать физику мира.
Ребёнок десятки тысяч раз роняет вещи.
Трогает их.
Двигает.
Проверяет.
Человеческий мозг накопил потрясающую систему обучения, выточенную сотнями миллионов лет эволюции.
Роботу мы пытаемся выдать похожий объём знаний за несколько месяцев.
И платим за ускоренную программу обучения электричеством и видеокартами.
Если смотреть с этой точки зрения, миллиарды выглядят уже чуть менее безумно.
Причём полотенце неожиданно сложнее автомобиля
Самые неприятные объекты для роботов иногда выглядят совершенно безобидно.
Полотенце.
Футболка.
Одеяло.
Шнур.
Пакет.
Жёсткая коробка предсказуема.
У неё есть форма.
Углы.
Размер.
Ткань меняется после каждого прикосновения.
Взяли полотенце за угол — оно висит одним образом.
Схватили посредине — другим.
Положили на кровать — появилась новая конфигурация складок.
Чтобы сложить его, робот должен постоянно оценивать форму мягкого объекта, которую сам же меняет каждым движением.
Человек выполняет это почти автоматически.
Для машины это комбинация компьютерного зрения, физики, управления двумя руками и обратной связи.
Поэтому показ Figure с двумя роботами, которые вместе застилают кровать, на самом деле технически интереснее очередного сальто.
Хотя просмотров сальто обычно собирает больше.
Получается новая версия закона масштабирования
Figure утверждает, что при увеличении объёма данных предварительного обучения качество поведения робота растёт довольно предсказуемо.
Очень похоже на scaling laws языковых моделей.
Добавляем данные.
Добавляем вычисления.
Ошибка уменьшается.
Если закономерность сохранится, возникает соблазн сделать то же, что AI-компании уже сделали с LLM.
Просто продолжать масштабировать.
Десять тысяч GPU.
Сто тысяч.
Миллион.
И смотреть, когда робот внезапно начнёт переносить знания между задачами почти так же естественно, как человек.
Но здесь появляется неприятная экономическая сторона.
Универсальность стоит чудовищно дорого
Допустим, бизнесу нужно автоматизировать склад.
Робот должен брать три типа коробок.
Переносить их между четырьмя точками.
Работать в фиксированном помещении.
Можно построить довольно специализированную систему.
Теперь скажем:
робот должен работать на любом складе;
понимать любые коробки;
открывать любые двери;
общаться с людьми;
самостоятельно разбираться с новой обстановкой.
Цена интеллекта взлетает.
А если добавить:
пусть после смены ещё съездит домой и застелет кровать,
— добро пожаловать к контракту на миллиарды долларов вычислений.
Универсальность — очень дорогая функция.
И для бизнеса это, пожалуй, главный урок всей истории
Компании часто смотрят на самые громкие AI-проекты и делают неправильный вывод:
нам тоже нужен универсальный ИИ, который умеет всё.
Чаще всего — нет.
Figure действительно нужен почти универсальный физический интеллект, потому что её робот должен войти в тысячи разных домов и производств.
У обычного бизнеса ситуация противоположная.
Чем точнее мы ограничили среду и задачу, тем дешевле и надёжнее автоматизация.
Не «ИИ занимается всем маркетингом».
А:
получает данные о конкретном бизнесе;
анализирует конкретный рынок;
готовит оффер;
собирает рекламу;
обрабатывает лиды по известному процессу.
Именно поэтому мы строим Market GPT как набор связанных специализированных контуров, а не пытаемся сделать одного волшебного цифрового директора, которому сказали: «заработай мне денег».
Тот же принцип постоянно разбираю в GPT-Лаборатории: хороший автомат обычно начинается не с выбора самой умной модели, а с ответа на скучный вопрос — какую именно часть процесса мы ей разрешаем делать?
У Figure просто нет роскоши сильно сузить задачу.
Роботу придётся жить в нашем хаосе.
И поэтому Physical AI может оказаться даже дороже обычного ИИ
Большая языковая модель изучает созданный людьми цифровой мир.
Роботу придётся изучить настоящий.
А настоящий мир содержит слишком много вариантов.
Каждый предмет можно взять десятками способов.
Каждая комната отличается.
Каждая поверхность создаёт трение.
Каждый человек двигается немного иначе.
Объекты падают.
Мнутся.
Ломаются.
Проскальзывают.
Заслоняют друг друга.
И всё происходит в трёхмерном пространстве с физическими последствиями.
Нам казалось, что самая сложная часть гуманоидного робота — построить тело.
Теперь постепенно выясняется: тело можно производить на заводе.
Самая дорогая деталь будет невидимой.
Опыт.
Миллиарды часов того, как люди двигаются в мире.
И миллиарды долларов вычислений, чтобы из этого опыта сделать одну модель.
Зато если ставка Figure сыграет, результат будет огромным
У языковой модели есть очевидный предел среды.
Она живёт в цифровом мире.
Робот получает доступ к физической экономике.
Склады.
Заводы.
Магазины.
Отели.
Больницы.
Дома.
Строительство.
Логистика.
Там по-прежнему выполняется огромное количество работы, которую невозможно автоматизировать только API.
Поэтому компании и готовы вкладывать такие деньги.
Если один foundation model действительно научится переносить навыки между тысячами физических ситуаций, стоимость обучения можно распределить на миллионы будущих роботов.
Тогда те самые $3,5 миллиарда начинают выглядеть не как стоимость умения складывать полотенце.
А как стоимость попытки создать Windows для человеческого тела.
Одну систему управления, которую можно поставить на миллионы одинаковых машин.
Осталось доказать маленькую деталь
Что масштабирование действительно продолжит работать.
56% успешных выполнений в незнакомой среде — огромный прогресс по сравнению с 9%.
Но человеку нельзя сказать:
— Я в 56 процентах случаев нормально застилаю кровать.
Работодатель будет слегка недоволен.
Настоящему домашнему роботу нужны показатели значительно ближе к стопроцентным.
И не на трёх задачах.
На сотнях.
Потом тысячах.
Причём без разбитой посуды, раздавленного кота и знаменитого сообщения:
«Извините, возникла непредвиденная ошибка при взаимодействии с лестницей».
Именно поэтому гонка только начинается.
Мы уже умеем построить впечатляющее механическое тело.
Умеем научить его отдельным действиям.
Начинаем переносить опыт между незнакомыми помещениями.
А теперь отрасль обнаружила цену следующего шага.
Чтобы робот просто вошёл в чужой дом и понял, что здесь делать, ему, возможно, сначала придётся прожить миллионы человеческих жизней внутри дата-центра.
И, судя по контракту Figure, счёт за это детство уже выставили.